ReWOO:把推理计划与工具观察解耦
ReWOO 先一次性生成带依赖的完整计划,再由 Worker 执行工具,最后由 Solver 汇总; 避免 ReAct 每一步都把不断增长的 observation 送回 Planner。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models |
| 公司 / 机构 | Microsoft Research / North Carolina State University / Texas A&M University |
| 首次公开日期 | 2023-05-29 |
| 原作者代码 | 已开源:billxbf/ReWOO |
| 本地 adapter / CLI key | rewoo |
| 本地复现代码 | src/auto_research/agent_research/ |
原始论文总结
背景与主要改动
ReAct 在每次工具返回后重新调用 LLM,token 和推理成本随轨迹增长。ReWOO 的 Planner 用变量引用写出完整多步计划,Worker 只负责填入工具证据,Solver 最后读取计划与证据 生成答案,因此 Planner 不被中间观察反复打断。
flowchart LR
    X["任务"] --> P["Planner:完整 E#/P# 计划"]
    P --> W1["Worker 工具 1"]
    P --> W2["Worker 工具 2"]
    W1 --> E["证据表"]
    W2 --> E
    P --> S["Solver"]
    E --> S
S --> O["答案"]原论文关键图
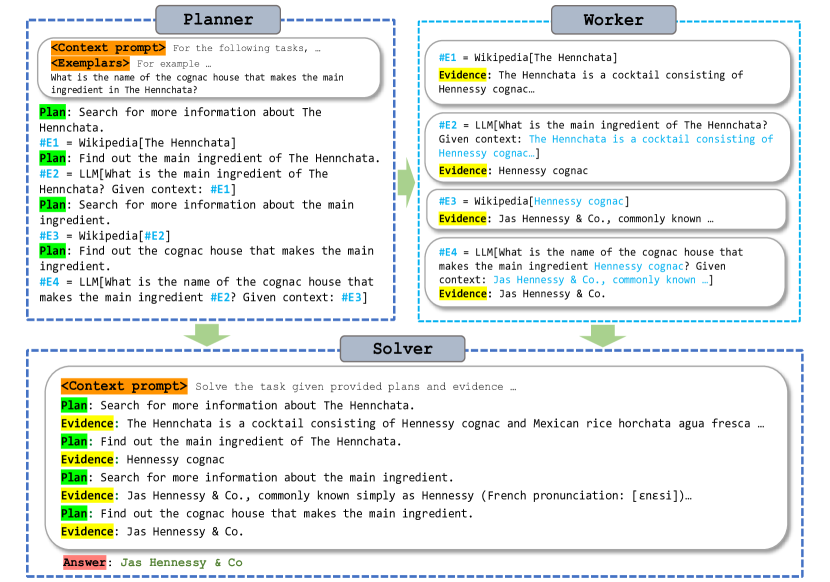
原论文 Figure 1(关键图):展示原论文的整体流程、关键阶段及其数据流向。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\[
P=\{(E_i,T_i,a_i(E_{<i}))\}_{i=1}^{n},\qquad
e_i=T_i(a_i(e_{<i})),\qquad y=S(x,P,e_{1:n}).
\]
论文离线与线上效果
论文报告约 5 倍 token efficiency,并在 HotpotQA 上相对基线提升约 4 个百分点,还展示 将 Planner 从 175B 模型卸载到 7B 模型的可行性;没有生产线上 A/B 实验。
本地复现
PlanBench mini 固定 120 episodes:joint success 1.0000、平均成本 3.5000, 生成 120 份完整计划并执行 360 次 worker/tool action。
稳定指标:
classic-agent-mini-suites-seed42.json。
复现边界
实现 Planner/Worker/Solver 解耦、显式依赖与证据汇总;本地没有真实搜索 API 和多尺寸 LLM,因此只验证控制流与调用计数,不复刻 HotpotQA 的语言生成分数。