RLAIF:用 AI 偏好替代昂贵人工标注
保真度:核心机制复现。本页不把确定性 mini-suite 冒充原论文完整 benchmark。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | RLAIF:用 AI 偏好替代昂贵人工标注(arXiv 2309.00267) |
| 公司 / 机构 | Google Research / Google DeepMind |
| 首次公开日期 | 2023-09-01(arXiv v1) |
| 原作者代码 | 未发现/未发布原作者独立训练仓库 |
| 本地 adapter / 方法键 | rlaif |
| 本地复现代码 | src/auto_research/post_training/ |
原始论文总结
背景与主要改动
AI labeler 对候选做顺序交换评判,去除位置偏差后训练 preference policy;本地落实双顺序标签与成对更新。
flowchart LR
 A["公开输入 / 历史"] --> B["rlaif 训练 / 执行闭环"]
 B --> C["论文特有状态或目标"]
C --> D["同预算评测"]原论文关键图
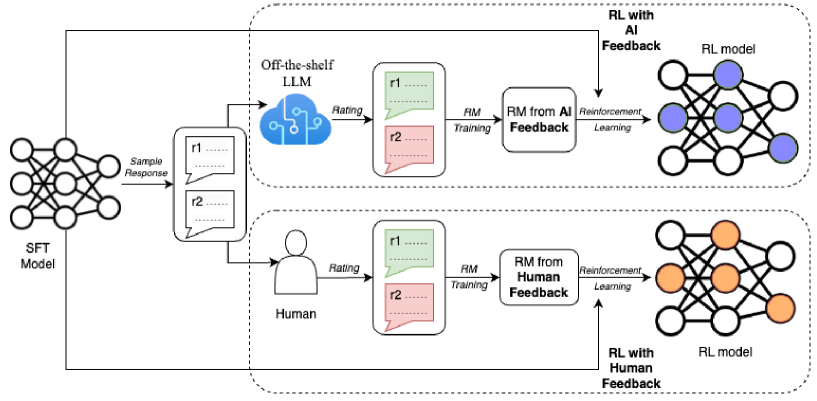
原论文 Figure 2(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\[
\hat r=\tfrac12[r_{AI}(a,b)+r_{AI}^{swap}(b,a)],\quad\mathcal L=-\log\sigma(\log\pi(y^+)-\log\pi(y^-)).
\]
论文离线与线上效果
RLAIF 在摘要、helpful 与 harmless 对话上达到与 RLHF 相当表现,direct-RLAIF 更强。 论文未报告生产线上 A/B,本页不补造线上数字。
本地复现
Arithmetic candidate suite、120 steps、256 examples、seed 42:accuracy 0.2344 → 0.6406(+173.33%);奖励、KL、长度和候选预算一致。
auto-research post-train --algorithm rlaif --dataset arithmetic-smoke --maximum-examples 256 --steps 120 --seed 42
auto-research evolve --model post-training --dataset arithmetic-smoke --direction "组合 rlaif 与已安装论文算子" --generations 2 --population 4
固定指标见 ../../experiments/global-p0-20260808-seed42.json。
复现边界
本地只验证论文特有目标、状态更新和公平预算;没有复刻原论文的大模型、多卡 RL、私有环境、真实网页或完整 benchmark,因而只报告机制验证,不声称数值复现原表。