SASRec:Self-Attentive Sequential Recommendation
保真度:完整核心链路复现。模型、原论文 pairwise BCE 训练目标与序列推理均实际执行;仅把公开数据从 MovieLens-1M 缩到 MovieLens-100K,并采用更严格的全库评估。
论文信息
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 1808.09781 |
| 公司/机构 | UC San Diego |
| 首次公开日期 | 2018-08-20(arXiv v1) |
| 原文开源代码 | 是:官方/作者代码 |
| Adapter | sasrec |
| 本地复现代码 | src/auto_research/reproductions/sasrec/ |
原始论文总结
背景与主要改动
Markov Chain 偏重最近行为,RNN 又需要逐步计算。SASRec 用因果自注意力直接选择序列中与下一物品相关的行为,在稀疏与稠密数据之间取得更灵活的感受野,并成为序列推荐常用基线。
flowchart LR
    S["按时间排序的 item IDs"] --> E["共享 item embedding + position"]
    E --> A["Causal multi-head self-attention"]
    A --> F["Point-wise ReLU FFN"]
    F --> R["Residual + LayerNorm"]
    R --> T["与共享 item embedding 点积"]
T --> O["下一物品全库分数"]原论文关键图
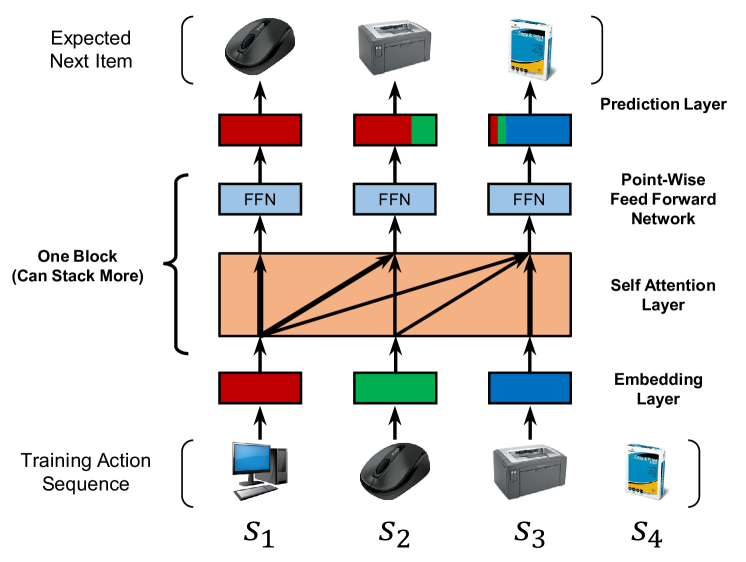
原论文 Figure 1(关键图):展示原论文的训练流程与关键优化环节。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
对序列表示 \(E\),每层执行
物品输入 embedding 与输出分类权重绑定。原论文目标对每个位置的正物品和采样负物品使用 pairwise BCE,本实现保留该目标。
论文离线与线上效果
- 离线:论文在 ground-truth + 100 个采样负例协议下报告 Hit@10/NDCG@10:Beauty 0.4854/0.3219,Games 0.7410/0.5360,Steam 0.8729/0.6306,MovieLens-1M 0.8245/0.5905。
- 在线:论文没有报告真实生产线上 A/B。
SASRec 是用户明确指定的经典基线例外;它不改变新增工业论文必须有量化线上 A/B 的规则。
本地复现
本地对照口径:基线是 popularity 排序;实验组是 SASRec;主指标 NDCG@10 从 0.02969 降至 0.02933(-1.24%)。这是跨模型基线比较,不是 SASRec 模块消融。
MovieLens-100K,932 个有效用户、1,682 个物品,时间顺序 leave-two-out;种子 42/43/44,每个 320 step,Apple MPS。评估对完整物品库排序,显著难于论文的 100 个采样负例,因此绝对值不可直接横比。
| Model | Hit@10 | NDCG@10 | Head share@10 |
|---|---|---|---|
| Popularity | 0.06009 | 0.02969 | 1.00000 |
| SASRec | 0.05830 ± 0.00395 | 0.02933 ± 0.00051 | 0.97775 |
SASRec 相对 popularity 的 NDCG@10 为 -1.24%。结果在三个 seed 上稳定但没有超过强 popularity;它提供了可复用、协议明确的神经序列基线,也暴露出短训练预算下的头部偏置。
审计指标见 metrics/movielens-100k-seeds42-44.json。