Learning Transferable Visual Models From Natural Language Supervision
保真度:核心机制复现。原文结论、本地公开数据实验和未复刻部分分开陈述。
论文信息
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2103.00020 |
| 公司/机构 | OpenAI |
| 首次公开日期 | 2021-02-26(arXiv v1) |
| 原文开源代码 | 是:官方/作者代码 |
| Adapter | clip |
| 本地复现代码 | src/auto_research/reproductions/clip/ |
原始论文总结
背景与主要改动
用独立图像/文本 encoder 将配对样本映射到同一单位球面,通过双向 batch contrastive objective 学习可迁移零样本表示。
flowchart LR
 A["公开输入"] --> B["clip 核心机制"]
 B --> C["同预算训练 / 执行"]
C --> D["公开评测与诊断"]原论文关键图
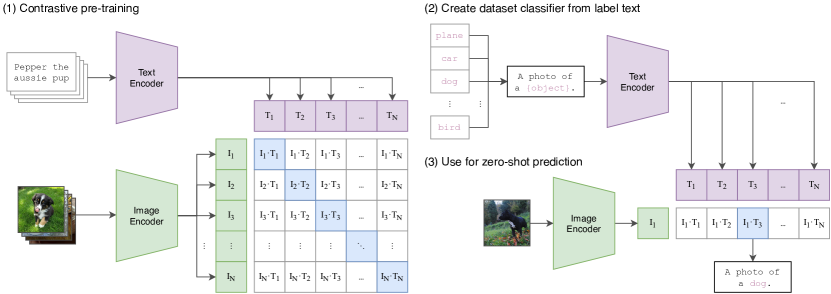
原论文 Figure 1(关键图):展示原论文的训练流程与关键优化环节。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\[
\mathcal L=\tfrac12\operatorname{CE}(I T^\top/\tau,y)+\tfrac12\operatorname{CE}(T I^\top/\tau,y).
\]
论文离线与线上效果
4 亿图文对预训练;ImageNet zero-shot 达到原始监督 ResNet-50 水平,并评测 30 多个数据集。
本地复现
本地对照口径:在真实 Fashion-MNIST 图像与类别文本构成的 10 类图文任务上,基线为均匀随机检索(10.0%),实验组为对称式图文对比学习双塔;测试准确率达到 72.0%(+62.0 个百分点),打乱图像后降至 10.3%,说明结果依赖视觉输入。
固定指标见 metrics/fashion-mnist-qa-seed42.json。
复现边界
使用 Fashion-MNIST 的真实像素与类别文本复现双塔、归一化和对称式对比目标;没有复刻 4 亿图文对、自然语言长尾语义或大规模视觉 encoder。单 seed 小预算结果只验证机制可执行,不等价于原论文 zero-shot 指标。