M6-Rec: 把预训练语言模型变成开放式推荐系统
Fidelity: 核心机制复现。真实执行冻结预训练 Transformer、自然语言用户行为、option tuning 与逐层 bottleneck option-adapter tuning;M6 生产模型、私有数据和 early-exit/pruning serving 未复刻。
论文信息
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2205.08084 |
| 公司/机构 | Alibaba |
| 首次公开日期 | 2022-05-17(arXiv v1) |
| 原文开源代码 | 否:论文未提供官方/作者代码(核查日期:2026-08-09) |
| Adapter | m6rec |
| 本地复现代码 | src/auto_research/reproductions/m6rec/ |
原始论文总结
背景与主要改动
传统推荐模型为排序、召回、解释、对话分别维护架构。M6-Rec 把匿名行为序列和候选物品都改写成自然语言,让一个生成式预训练模型统一完成排序、召回、zero-shot、解释、内容生成和对话。为避免每个场景完整微调巨型 M6,论文提出 option tuning 和 option-adapter tuning,只训练约 1% 的任务参数;线上再用 late interaction、early exit、参数共享和剪枝得到 10M/2M 的 M6-Edge。
flowchart LR
  A["匿名行为日志"] --> B["自然语言历史与候选"]
  B --> C["冻结 M6 预训练主干"]
  C --> D["逐层 option adapter"]
  D --> E["候选 option 得分"]
  E --> F["CTR 排序 / 语义召回"]
C --> G["解释、内容生成、对话"]原论文关键图
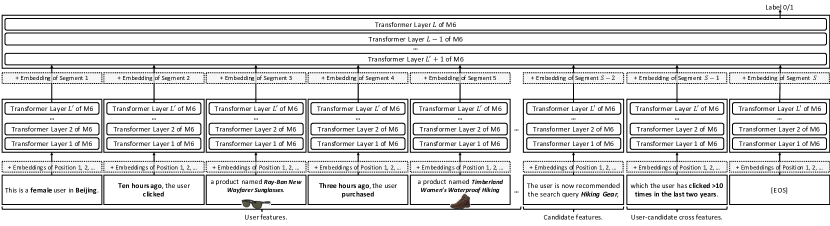
原论文 Figure 3(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
对任务 \(t\),主干参数 \(\Theta\) 冻结,只优化 option 参数 \(O_t\) 和逐层 adapter \(A_t^l\):
本地二分类 option 得分采用归一化表示与两个可训练 option prototype 的相似度:
论文离线与线上效果
| Dataset / task | Production baseline | M6-Rec |
|---|---|---|
| AlipayQuery CTR AUC | DIN 0.7332 | 0.7508 |
| TaoProduct CTR AUC | DIN 0.7611 | 0.7995 |
| AlipayMiniApp HitRate@100 | TwinBERT 69.6% | 74.1% |
| Unseen mini-app HitRate@100 | TwinBERT 49.6% | 57.0% |
Alipay mini-app 线上以 TwinBERT 类双塔为生产对照,M6-Rec 带来 相对 CTR 超过 +1.0%,并从 2021 年 7 月起全量部署。这是本文进入实现队列的量化真实线上证据。
本地复现
本地对照口径:基线是只训练 option prototype 的 Option Tuning;实验组额外训练 24d adapter;AUC 从 0.53832 升至 0.53890(+0.12%)。这是 adapter 增量消融,不代表完整 M6-Rec 相对 DIN 或工业基线的提升。
使用真实预训练 prajjwal1/bert-tiny(4.4M 参数)作为可在 Mac 上迭代的 M6-Edge 级主干。每条样本包含用户此前喜欢的电影标题/类型和当前候选;按用户时间顺序切分。比较只训练两个 option prototype(256 参数)与同时训练两层 24d adapter(12,848 参数),主干在两组中均冻结。
3 seeds、每 seed 4,000 train / 1,000 test、80 steps:
| Method | AUC mean ± std | 相对 option-only |
|---|---|---|
| Option tuning | 0.53832 ± 0.01724 | — |
| Option-adapter tuning | 0.53890 ± 0.01516 | +0.12% ± 0.41% |
逐 seed 相对增益为 -0.36% / +0.07% / +0.65%。均值为正但方差大,因此本地只支持“adapter 有轻微趋势”,不支持稳定复现论文生产增益。结构化结果见 metrics/movielens-100k-seeds42-44.json。
pip install -e '.[plum]'
for seed in 42 43 44; do
  AUTO_RESEARCH_M6REC_STEPS=80 AUTO_RESEARCH_M6REC_EXAMPLES=4000 \
  auto-research reproduce --paper m6rec --dataset-dir data --seed "$seed"
done
模型缓存、数据和单次运行位于 Git 忽略目录;不提交 checkpoint。