Random Attention:无需重要性打分的 KV Cache 淘汰
复现级别:核心机制 + 真实 checkpoint GPU 验证。 保留完整 prompt,并对生成 trace 按 attention head 独立均匀随机采样。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | Salesforce AI Research preprint |
| 公司/机构 | Salesforce AI Research(第一作者第一署名单位) |
| 首次公开日期 | 2026-09-03(arXiv v1) |
| 原文开源代码 | 是:SalesforceAIResearch/Random-Attention |
| Adapter | random-attention |
| 本地复现代码 | src/auto_research/reproductions/random_attention/ |
原始论文总结
背景与主要改动
传统 KV 淘汰先计算 token 重要性,Random Attention 则始终保护 prompt,仅在已生成 token 中逐 head 独立随机保留固定预算;它省掉评分 pass,也避免所有 head 被同一排序规则约束。
flowchart LR
  P[完整 Prompt KV] --> K[保留]
  T[生成 Trace KV] --> S[逐 Head 均匀采样]
  K --> A[稀疏 Attention]
S --> A原论文关键图
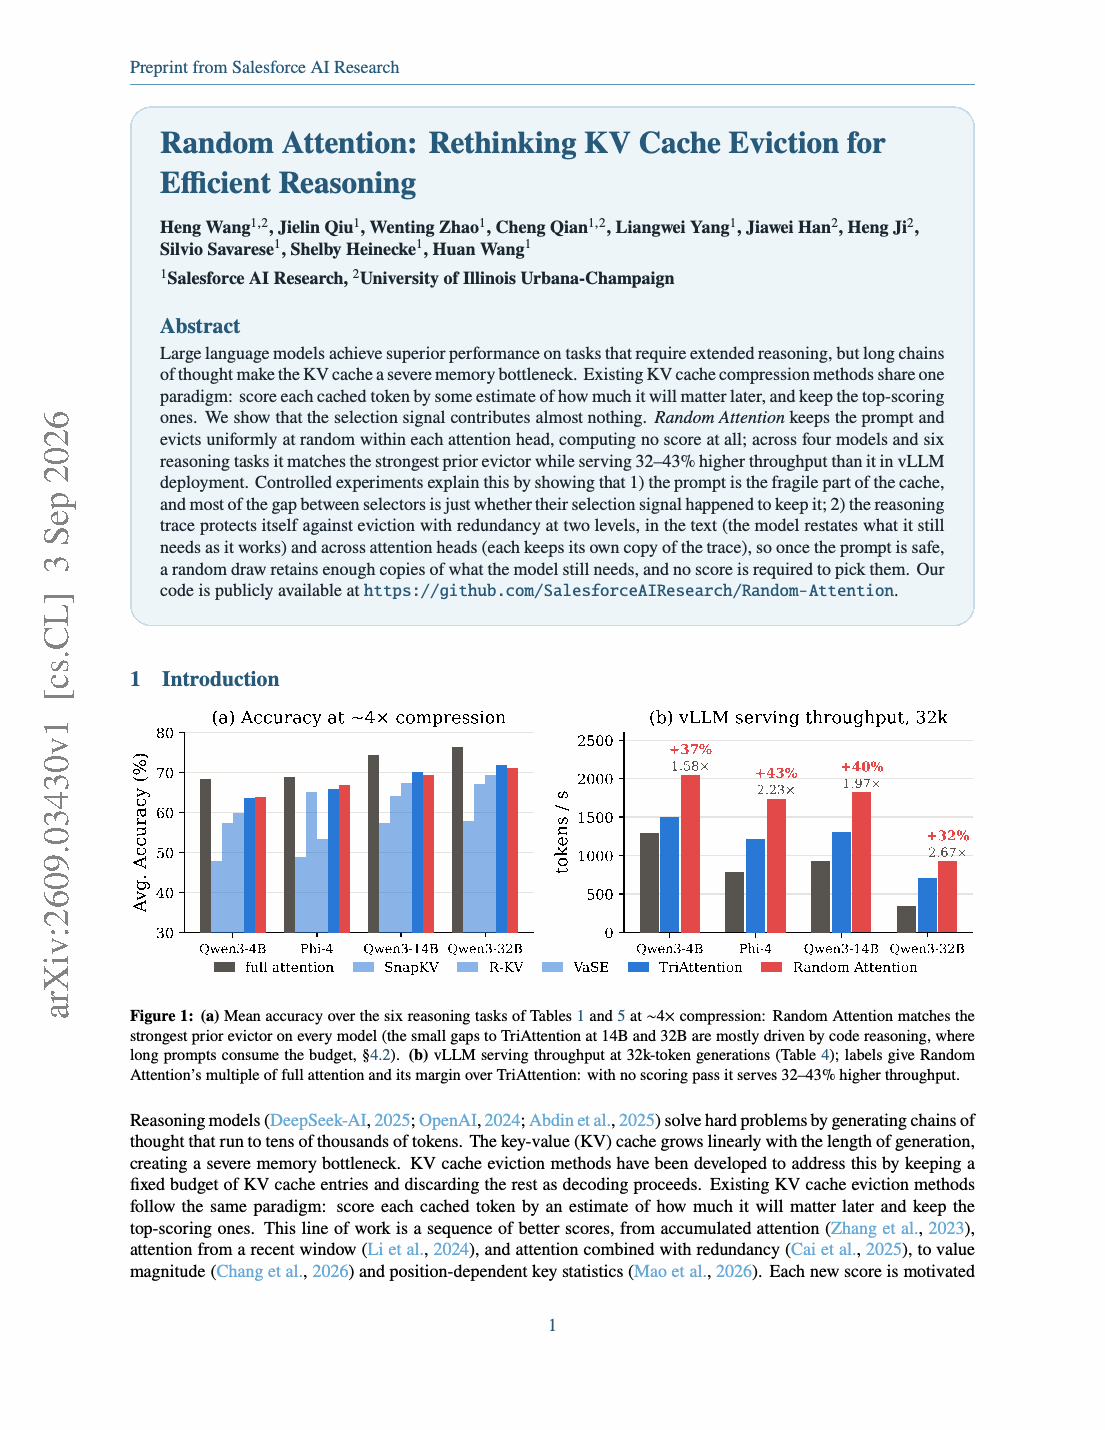
原论文方法与结果概览。图片来自原论文,版权归原作者所有。
核心公式
对 head \(h\),保留集合为 \(K_h=P\cup\operatorname{UniformSample}(T,B-|P|)\);\(P\) 是完整 prompt,\(T\) 是生成 trace,各 head 独立采样且不执行 token importance scoring。
论文离线与线上效果
论文在四个模型、六项任务和 32k 上下文验证,在相同 KV 预算下保持推理质量;接入 vLLM 后,相对最强重要性淘汰基线的吞吐提升为 32%–43%。
本地复现与 GPU 证据
CPU 三 seed 机制结果见 metrics/public-seeds42-44.json;真实 Qwen3-4B checkpoint、固定公开域长文本探针和 A100 运行回执见 ../../gpu-validations/random-attention-a100-20260906.json。验证严格使用等预算 prompt+recent 基线。
本地对照口径:CPU seed 42 的等预算 recent 基线 attention cosine=0.97996,随机实验组=0.46664,相对变化 -52.38%;A100 真实 checkpoint 诊断分别为 0.99996 与 0.94002,不据此宣称任务准确率提升。
复现边界
未声称复刻论文六任务矩阵和官方 vLLM kernel 吞吐;本地 GPU 路径验证真实 KV 张量上的选择与 attention 重建,并可作为 LLM Evolve attention 算子。