Read this paper write-up in English
Certified Selective Automation of LLM Agent Evaluation
复现级别:L1 核心机制诊断。 执行 task-cluster bootstrap certificate;mini-suite 证书不代表论文语料覆盖率。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | Certified Selective Automation of LLM Agent Evaluation |
| 公司/机构 | Independent Researcher(按第一作者署名单位) |
| 首次公开日期 | 2026-09-28(arXiv v1) |
| 原文开源代码 | 否:截至 2026-09-30 未找到原作者公开仓库 |
| Adapter / 方法 | certified-selective-eval |
| 本地复现代码 | src/auto_research/agent_research/latest_20260930_closure.py |
原始论文总结
背景与主要改动
按任务簇而非轨迹独立假设做 bootstrap,给自动判断区域的错误率建立上置信界,只有证书低于预算才自动接管。
flowchart LR
  I[公开输入/当前状态] --> M[certified-selective-eval 核心机制]
  M --> A[可审计中间量]
A --> O[输出/更新状态]原论文关键图
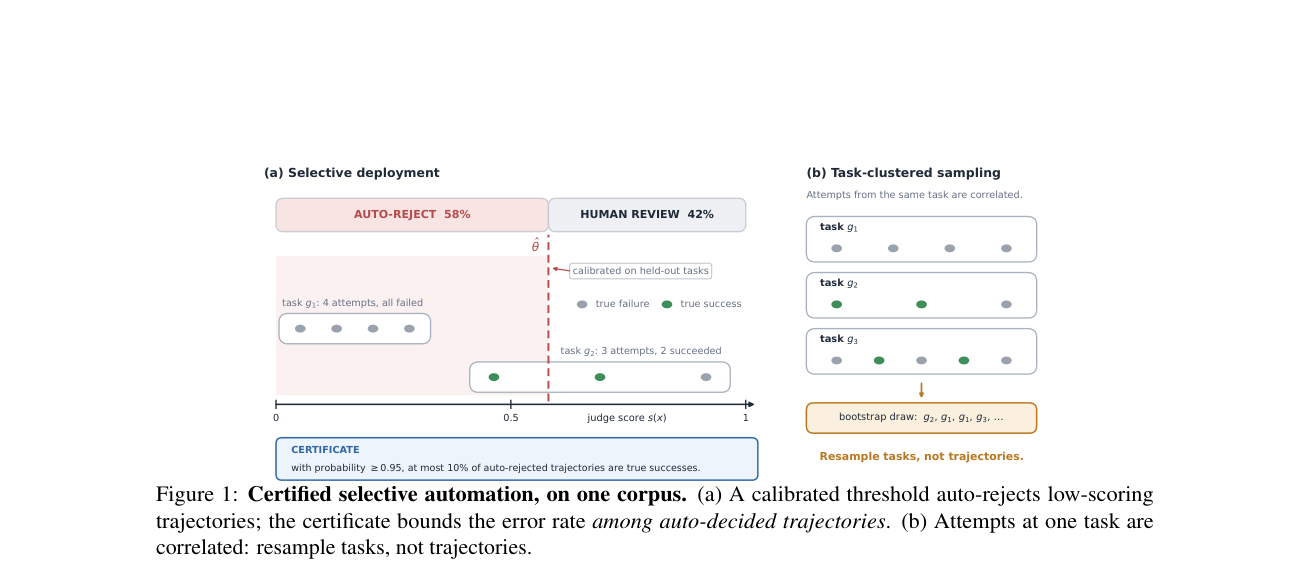
原论文 Figure 1(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
本地 reference kernel 保留论文决定性的门控、掩码、递归、信用权重或晋级条件;测试同时检查梯度隔离、类型边界和确定性。
论文离线与线上效果
论文中的 benchmark、速度或训练曲线属于原文结果。本地三种子 mini-suite 仅检验机制和不变量,不与论文规模结果横比,也不外推线上收益。
本地复现
三种子诊断见 metrics/mechanism-seeds42-44.json。其中 diagnostic_only=true,不能进入正式能力排名。
复现边界
执行 task-cluster bootstrap certificate;mini-suite 证书不代表论文语料覆盖率。