dQwen3.5: Adapting Hybrid Language Models into Bidirectional Diffusion Language Models
复现级别:L1 核心机制诊断。 本地执行双向混合状态 CUDA kernel;未加载 9B checkpoint 或复现预训练损失曲线。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | dQwen3.5: Adapting Hybrid Language Models into Bidirectional Diffusion Language Models |
| 公司/机构 | University of Texas at Austin(按第一作者署名单位) |
| 首次公开日期 | 2026-09-17(arXiv v1) |
| 原文开源代码 | 否:截至 2026-09-19 未找到原作者公开实现仓库 |
| 原文公开 checkpoint | https://huggingface.co/UT-IFML/dQwen3.5-9B-Base |
| Adapter / 方法 | dqwen35 |
| 本地复现代码 | src/auto_research/foundation_latest_20260919.py |
原始论文总结
背景与主要改动
把 Qwen3.5 的注意力/RNN 混合骨干改成双向状态传播,再以掩码去噪目标训练为 diffusion language model。
flowchart LR
  I[公开输入/当前状态] --> M[dqwen35 核心机制]
  M --> A[可审计中间量]
A --> O[输出/状态更新]原论文关键图
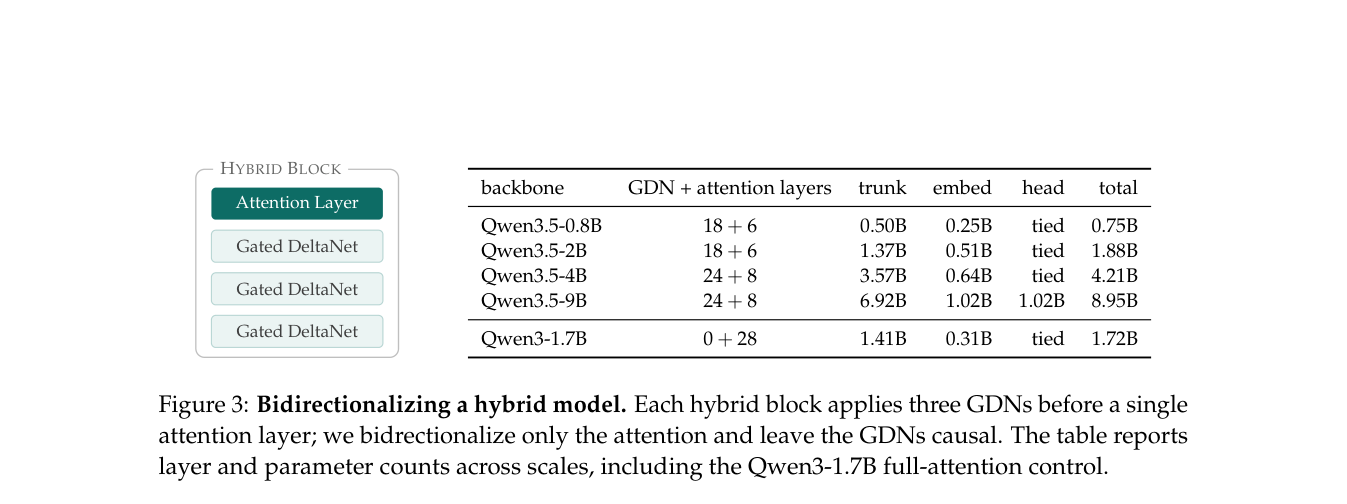
原论文 Figure 3(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
本地 reference kernel 保留论文决定性的门控、权重、状态转换或调度规则,并把中间量写入指标产物;具体公式与变量对应见实现函数及测试中的不变量断言。
论文离线与线上效果
论文报告的线上、benchmark、训练效率或推理速度只作为原文结果。本地三种子 artifact 只验证核心机制、形状和状态不变量,不与论文数字直接横比。指标见 metrics/mechanism-seeds42-44.json。
CUDA 路径已在真实 NVIDIA A100 上运行;脱敏 receipt 见 docs/gpu-validations/。
复现边界
本地执行双向混合状态 CUDA kernel;未加载 9B checkpoint 或复现预训练损失曲线。