On-Policy Delta Distillation for Multilingual Math Reasoning
复现级别:核心目标 candidate-policy mini-suite。 本地真实执行该论文独有的 advantage、蒸馏或约束更新;不是论文大模型训练的数值复刻。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | arXiv 2608.05802 |
| 公司 / 机构 | NAVER AI Lab |
| 第一作者 | Byeongho Heo |
| 首次公开日期 | 2026-08-06(arXiv v1) |
| 原作者代码 | 是:opd2 |
| 本地 adapter / 方法 | opd2 |
| 本地复现代码 | src/auto_research/post_training/historical_b08_b09.py |
原始论文总结
背景与主要改动
以 post-trained teacher 相对其 base model 的概率增量作为蒸馏信号,减少复制教师原有偏差。
flowchart LR
  P[同一 candidate policy] --> R[on-policy rollout]
  R --> M[opd2 核心目标]
  T[奖励 / 教师 / rubric] --> M
  M --> U[参数更新]
U --> R原论文关键图
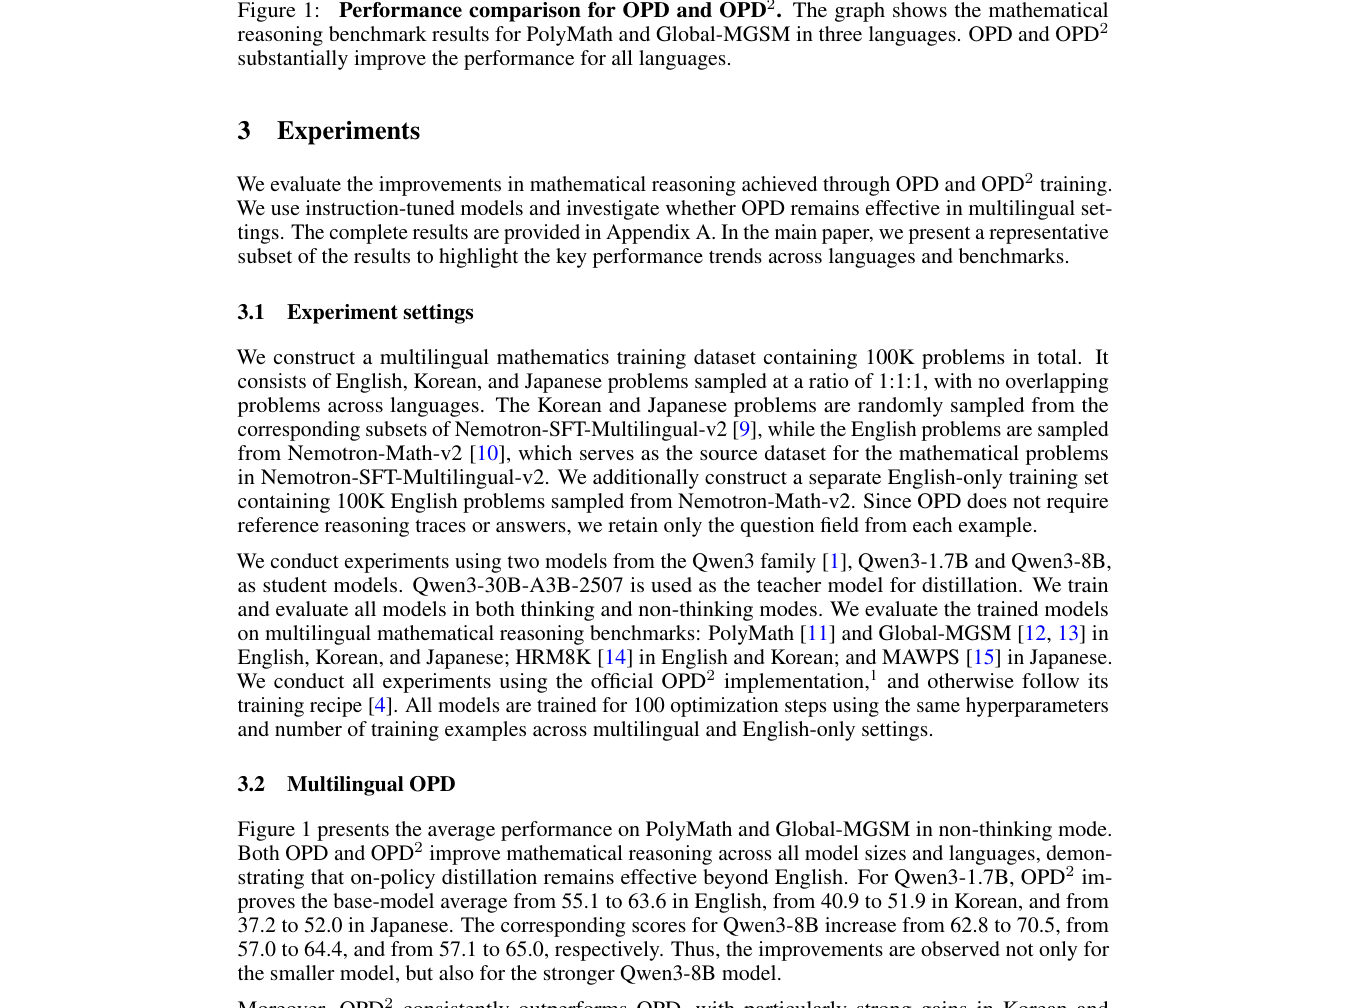
原论文 Figure 1(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\[
\Delta_T=\log p_{T^+}-\log p_{T^0}
\]
论文离线与线上效果
Qwen3 上持续优于原始 OPD,韩语和日语提升尤为明显。 以上为原论文报告值;论文没有工业线上 A/B 时不作线上效果推断。
本地复现
同一 arithmetic-smoke candidate policy 运行 120 次更新:训练前 accuracy 0.1953,训练后 0.6406,变化 +0.4453。这是训练前后 smoke 结果,不表示相对其他 RL/OPD 算法的公平优势。单篇原始指标见 metrics/arithmetic-smoke-seed42.json,批次索引见 ../../experiments/historical-b07-b11-seed42.json。
auto-research post-train --algorithm opd2 --dataset arithmetic-smoke --steps 120 --seed 42 --no-network
复现边界
本地策略是可审计 candidate-policy,复现论文的核心 objective 和诊断量;未下载论文大模型 checkpoint,未声称复刻其完整数据、算力、多 seed 或 benchmark。运行产物默认写入 runs/post-training/,仓库只提交指标,不提交 checkpoint。另见 ../../experiments/。