DistillCache: KL-Guided Adaptive KV-Cache Eviction for Memory-Efficient LLM Inference
复现级别:核心机制 mini-suite。 本地只验证论文可独立实现的算法路径,不把小规模 NumPy 实验冒充原论文规模训练或线上结果。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | arXiv 2608.08878 |
| 公司/机构 | Oklahoma State University |
| 第一作者 | Asaad Althoubi |
| 首次公开日期 | 2026-08-09(arXiv v1) |
| 原文开源代码 | 否:截至 2026-08-24 未发现原作者公开代码 |
| Adapter | distillcache |
| 本地复现代码 | src/auto_research/reproductions/distillcache/ |
原始论文总结
背景与主要改动
把 KV 淘汰视为序列决策,以逐步 KL 奖励训练轻量策略保留未来预测分布。
flowchart LR
  X[固定公开 mini-suite] --> B[recent-window 对照]
  X --> M[distillcache 核心机制]
  B --> E[同样本评测]
M --> E原论文关键图
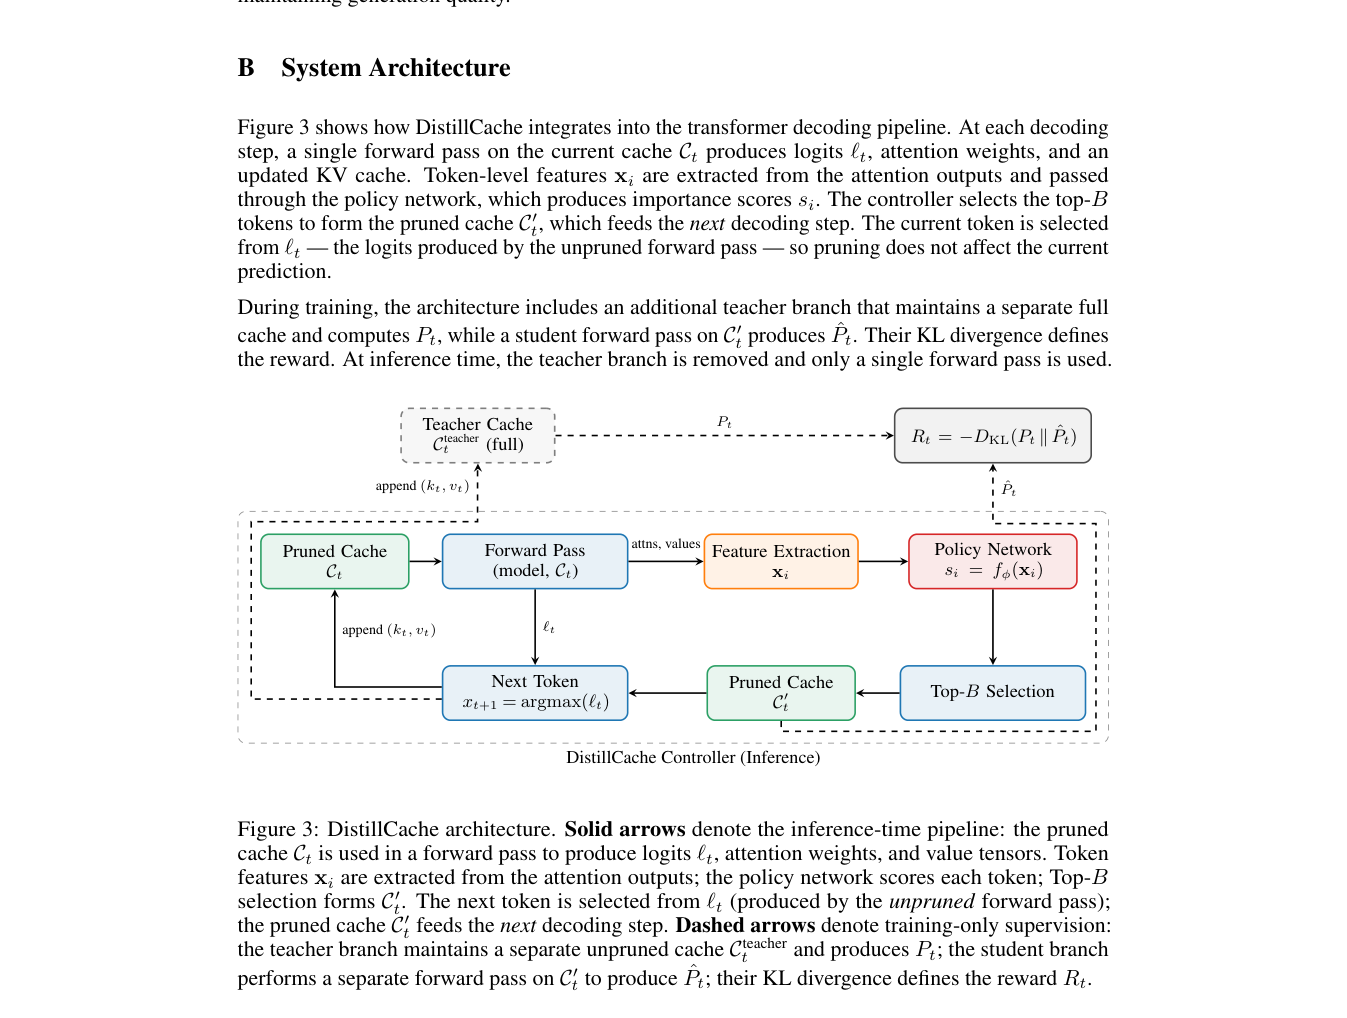
原论文 Figure 3(关键图):展示原论文的整体流程、关键阶段及其数据流向。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\[
r_t=-D_{KL}(p_{full,t}\Vert p_{evict,t})
\]
论文离线与线上效果
25% cache 预算保留 LongBench full-cache 94.2% 准确率,吞吐最高 2.1×。 这是原文口径;若原文没有工业 A/B,本页不会把本地结果写成线上收益。
本地复现
本地对照口径:基线为同样本
recent-window attention,实验组为distillcache;单 seed 变化为+92.19%个百分点。
同一 seed、同一 64 条样本上,recent-window attention baseline accuracy 为 0.0781,distillcache 为 1.0000,绝对变化 +92.19 个百分点。单篇原始指标见 metrics/public-seed42.json,批次索引见 ../../experiments/historical-b07-b11-seed42.json。
复现边界
本地使用固定长上下文/多模态/评测 mini-suite,未训练论文规模 checkpoint、未实现定制 CUDA kernel,也未复刻论文完整公开 benchmark。该实现用于确认核心数据流、公式和相对计算路径可执行。