Read this paper write-up in English
cast-opd:CAST: Credit Alignment for Cross-Tokenizer On-Policy Distillation
核心机制代码路径;短预算 checkpoint 结果只支持 runtime 诊断,不支持论文规模能力结论。
论文信息
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2610.13257 |
| 公司/机构 | Taobao & Tmall Group of Alibaba / Singapore Management University |
| 首次公开日期 | 2026-10-09(arXiv v1) |
| 原文开源代码 | 否:未找到原作者公开实现(2026-10-12 核查) |
| Adapter | cast-opd |
| 本地复现代码 | src/auto_research/reproductions/cast_opd/ |
原始论文总结
背景与主要改动
异构 tokenizer 的同一文本有不同分段,直接比较 token ID 无意义。CAST 先匹配实际解码文本,将教师 span 的总 log probability 均匀投影到学生 span,再按不确定性×局部平滑度分配 credit;未对齐位置通过初始学生 KL 限制漂移。
flowchart LR
  学生采样文本 --> 教师重新tokenize --> 解码文本span对齐 --> 教师分数投影 --> UScredit --> PPO更新
未对齐token --> 初始学生KL --> PPO更新原论文关键图
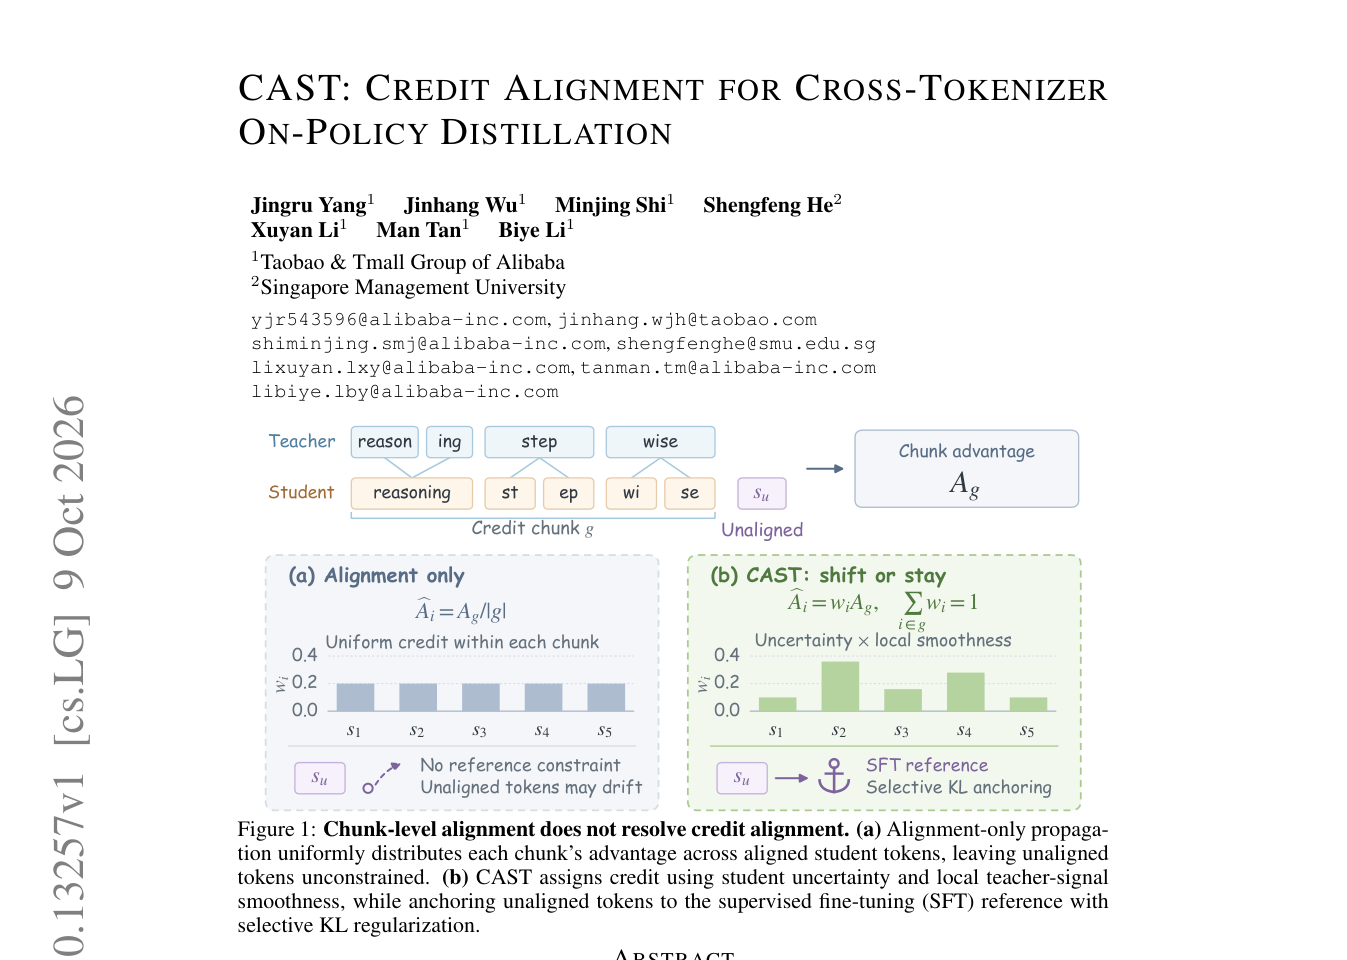
原版 PDF 第 1 页 Figure 1 全页截图,已检查图题、算法流程与正文,非本地重绘或实验产物。版权归原作者;截图来源为官方 arXiv PDF v1。
原论文关键图
原论文 Figure 1(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
对 credit chunk \(g\),\(A_g=\sum_{i\in g}(\tilde\ell_i^T-\ell_i^S)\)。\(\epsilon_g=\max(\mathrm{mean}\delta_i,0.1)\),\(w_i\propto\max(H_i,10^{-8})/(\delta_i+\epsilon_g)\),\(\hat A_i=A_gw_i\),因此总 credit 保持。未对齐位置令 \(z_i=\log\pi_0(a_i|s_i)-\log\pi_\theta(a_i|s_i)\),anchor 为 \(\min(e^{z_i}-z_i-1,d_{max})\)。
论文离线与线上效果
原文跨 tokenizer Qwen3-8B→Mistral/Llama 相对最强对照 Avg-6 改善 2.45/1.32 个百分点;三 seed CAST 平均为 47.01±0.28 与 43.72±0.16。Table 4 matched uniform control 为 45.07%,CAST 为 47.22%。未报告线上 A/B。 原论文标量摘录见 paper-results.json,paper_reported=true、measured_locally=false;独立存放于非 metrics 目录,不能作为本地复现指标。
本地复现
本地对照口径:基线为未蒸馏的相同student checkpoint,实验组执行异构tokenizer文本span对齐与credit/anchor训练;本地弱teacher短运行不证明有效知识迁移,稳定相对提升不适用。
首选入口:PYTHONPATH=src python scripts/run_oct12_post_training.py --objective cast-opd --help。本脚本保留 --objective cast 兼容别名,进入损失分支前统一为 cast-opd,输出 adapter_key 也只用规范 key;别名不注册为另一份 packaged adapter,也不改动旧 Agent CAST。
必须提供本地 student/teacher checkpoint 路径与公开 ID/revision、公开 train/validation JSONL、dataset revision、train-only split manifest 和 output 路径。 CLI 不下载模型,不上传数据,实际训练 q_proj/v_proj LoRA。
cast-opd packaged adapter 只读取数据目录中的 oct12-cast-opd.json,字段对应 CLI 的 snake_case 参数;其中 objective 可省略或设为 cast-opd,兼容值 cast 会先规范化。其它论文 objective、旧 key cast 的 packaged 绑定及旧文件 oct12-cast.json 都不会被静默接入;没有真实 checkpoint 配置时明确报错,不回退到合成 fixture。
数据协议与结果
必须复用 public_holdout.validate_holdout 校验公开 source train、revision、文件 SHA256、条数、规范化 question 去重及 train/validation 不重叠。学生生成只接收问题;gold 不进入 solver rollout/retrieval。validation 仅训练后报告,本短跑没有据 validation 选超参;test 无入口且不读取。正式实验的选参必须仅使用 train/validation。
CLI 强制异构 tokenizer,默认独立 2 rollouts、6-token credit chunk。NFKC/decoded-whitespace 规范化;含 Unicode replacement 或超过 32 token 的 span 留为未对齐。不是同词表加权 loss 冒充 cross-tokenizer。暂未实现共享 tokenizer 的标点 chunk 变体。
已完成规范 cast-opd key 的真实 NVIDIA A100 重跑,执行快照为 6765289590741a1b656dde7f3d0495349c70f485。本地测量见 gsm8k-a100-42.json:2-step、seed 42、每次 2 rollouts、最多 128 输出 token,512 aligned tokens、0 unaligned tokens、LoRA 参数变化 L2 为 0.007753067897551781;4 题 validation exact match 仍为 0。两步 loss 为 0.6927358508110046 / 0.9769706130027771,梯度 L2 为 0.8826789855957031 / 0.969049334526062。这次实跑数值与旧运行相同,未把失败结果改写为提升。教师规模小于学生,只支持异构 tokenizer runtime 诊断,不是有效知识迁移;全对齐结果仍不覆盖未对齐 KL 分支。
新 GPU 回执 记录真实规范 key、执行 commit、固定公开 checkpoint/data revision 与逐文件源码 SHA256;哈希来自该 commit 的 git show,不取当前 HEAD 或 dirty 文件。passed 仅表示该快照的 CUDA 机制运行完成,不覆盖当前工作区全部后续修改。旧 cast 测量、旧 command/commit/hash 及当时的 pending_rerun 标记原样保存在 历史命名迁移记录,不再放入 dashboard 的 metrics 作为当前验证。少量截断响应、单 seed 只支持 L1 runtime smoke,不报告稳定能力指标。
代码映射与复现边界
decoded_alignment / project_teacher_scores / credit_chunks / cast_credit / selective_anchor 与 cast_step 覆盖 retokenization、greedy decoded spans、advantage 保持和实际参考 KL。
契约与行为测试:test_oct12_post_training.py。小因果模型测试仅验证真实梯度、masked prefix、参考恢复、边界更新及 gold 隔离;不是 reasoning 能力比较。尚未完成论文规模数据/模型/长推理预算、多 seed 同预算能力对照、线上系统或 Evolve 控制器集成。