Read this paper write-up in English
Beyond the Final Embedding:用已有内容 token 寻找记忆证据¶
论文信息¶
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2610.13277 |
| 公司/机构 | Southeast University / MemoraX AI / Leiden University / University of Sydney |
| 首次公开日期 | 2026-10-09(arXiv v1) |
| 原文开源代码 | 否:原文与官方页面未找到作者代码(核查 2026-10-13) |
| Adapter | beyond-final-embedding |
| 本地复现代码 | src/auto_research/reproductions/beyond_final_embedding/ |
原始上传为 2026-10-09 09:27:55 UTC;与 NEAR 同作者团队,但中心算法是 token 证据检索,不是邻域 residual。两者独立比较,未推断它们可以直接叠加。
原始论文总结¶
背景与主要改动¶
最终 pooled embedding 会丢掉局部事实线索,但冻结 embedding encoder 的最后层 token states 已经含有上下文证据。论文保留内容 token(排除 query prefix、special tokens 和 padding),离线给每条 token 绑定原 memory ID。在整个候选 bank 中做全局稀疏 token top-k,再按 ID 聚合回 memory 排名;不是对每条 memory 独立 MaxSim 后排序。
对于未返回的 token–memory 匹配,使用每个 query token 的最差返回匹配(裁到非负)作为统一 floor。局部 sparse 分支和完整 pooled 分支都进行 query-wise 标准化,再融合。某 memory 没有任何 token 被返回,也仍能因 pooled 分支进入最终结果。可选的 query-only 低秩 residual 不改变 encoder、memory bank 或 pooled query。
架构流程¶
graph LR
 M[memory文本] --> E[冻结encoder一次前向]
 E --> P[原生pooled向量]
 E --> T[内容token与memory ID静态索引]
 Q[query文本] --> QE[同冻结encoder]
 QE --> A[可选norm-preserving queryadapter]
 A --> K[全bank稀疏top64 token匹配]
 T --> K
 K --> S[tail floor与memory ID聚合]
 P --> F[querywise标准化与local-global融合]
 S --> F
 QE --> F
F --> R[原memory级别排名]上方为本地重绘示意,源码:architecture.mmd;固定全文来源见 source-provenance.json。
原论文关键图¶
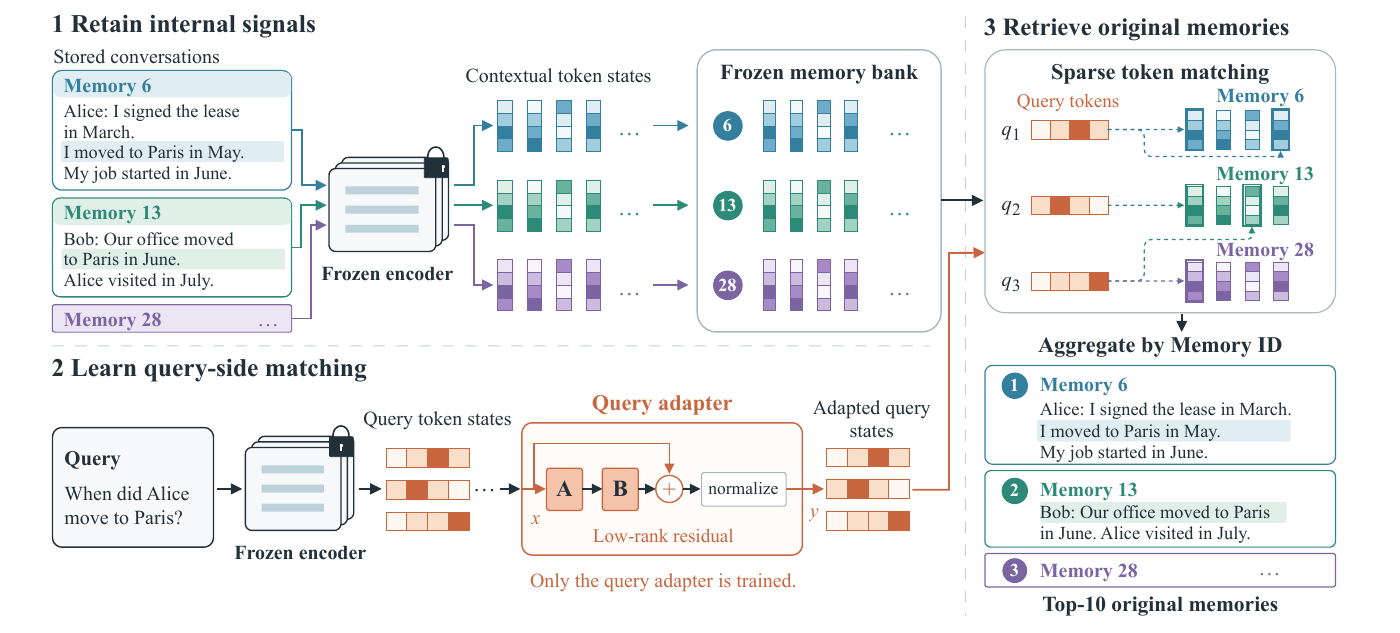
图 2:冻结 encoder 保留 memory 的 contextual token state 与源 memory ID;query token 从固定 bank 稀疏匹配证据,按 memory ID 聚合,并与 whole-memory similarity 融合为最终 memory 排名。橙色低秩残差 adapter 为可选项,只训练 query 侧,memory、encoder 与索引保持不变。图中对话和 ID 是原作者示意,不是本地数据或 gold 标签。来源:Luo 等,v1 Figure 2,原 PDF 第 3 页。
此图为原文 PDF 的 250 dpi 局部截图,图内文字未改写,已视觉核验;不是本地测量。论文标注 arXiv perpetual non-exclusive license,并非 CC BY;图示版权仍归原作者。PDF/图片 SHA256、页码与裁切范围见 original-figures.json。
原论文 Figure 2(关键图):上文说明所选原图或方法截图的范围;并非本地测量。图片来自原论文,版权归原作者所有;点击图片可查看固定版本来源。
核心公式¶
对每个 query token 的返回集合 \(\mathcal R_i\),floor 为 \(t_i=\max(0,\min_{h\in\mathcal R_i}h_{q,i}^Th)\)。按原 memory ID 聚合:
可选 query adapter 的 bias-free \(BA\) 不含激活,并保持输入范数:
用 all-memory MaxSim 的多正例 cross-entropy 训练 adapter(温度0.07),而推理仍为稀疏 token 搜索。不能以 ANN 离散 neighbor selection 的假梯度代替该 surrogate。
论文离线与线上效果¶
| 原文 Qwen-4B 八任务平均 | Recall@10 | NDCG@10 |
|---|---|---|
| 原 embedding | 62.5 | 48.0 |
| 原 token MaxSim | 67.8 | 54.3 |
| 本方法 training-free | 73.8 | 59.9 |
| 本方法 query-adapted | 75.7 | 62.3 |
来源:原文 §5。Qwen-4B native downstream QA accuracy 为 LoCoMo 67.86%(Base63.44%)、LongMemEval72.60%(67.80%)。可选 adapter 在一些 backbone 有负增益;局部证据和 pooled 融合互补。SQ4 在原设置减小 storage,RP128+SQ4 会损失质量;不能把这些原文结果放进本地 dashboard。未报告生产线上 A/B。
本地复现¶
本地对照口径:基线为同冻结 MiniLM 的原生 pooled cosine,实验组为真实 sparse-token fusion 及 source训练的 queryadapter;原文规模相对效果不适用。
PYTHONPATH=src python scripts/run_oct13_memory.py --paper beyond-final-embedding \
  --raw-data /path/to/longmemeval_s_cleaned.json --model-dir /path/to/minilm \
  --device cuda --seed 42 --max-queries 100 --max-length 128 --batch-size 16 --adapter-epochs 2 \
  --split-policy query-disjoint-shared-bank --diagnostic-only \
  --output runs/beyond/seed42.json
数据协议、结果与边界¶
复用 NEAR 的固定公开资源与连通 bank 分组协议。提取时 eval().requires_grad_(False),同一次编码同时提供原生 masked-mean pooled 向量和去除 special/padding 的 normalized content tokens。全部 candidate memories 保留,文本限长预先固定,不能根据 gold 选 memory/token。
训练 rank32 query residual,用训练 split 的 relevance 标签做真实多正例 MaxSim CE,optimizer 为 AdamW、lr1e-4、wd1e-4、clip1。epoch0/1/2 和 α0.25/0.5/0.75 只看 validation NDCG;选好后只执行一次最终 adapted test,并另报告预先固定 α0.5 training-free 对照。encoder、memory tokens 和 pooled query 从未更新。原文 EvoTrain 源监督替为 LongMemEval 训练 split,明确不是跨数据集泛化复现。
采用 exact 全局 top64 token search,是原文附录 D 的精确检索对照,不报告 HNSW 加速指标。标签仅进入训练 loss 或 evaluator,reference answer 不出现在 encoding 输入;原始 Skill/Agent gold plan 从未用来构造 query。行为合同见 implementation-contract.json;实际 GPU 诊断结果与负结果如下,不能以合同 fixture 代替真实测量。
当公开候选库无法做严格 bank 分组时,可显式加 --split-policy query-disjoint-shared-bank。同一冻结 memory/token bank 可共享,但 queryadapter 只接收训练 query 的 relevance loss,validation/test labels 不进入更新;所有选择仍只看validation。该固定索引诊断标记 shared-unlabelled-memory、diagnostic_only=true、promotion_eligible=false,不宣称未见 bank 泛化,不与默认严格协议混合;默认失败条件不被放宽。
2026-10-14 NVIDIA A30 实际结果与负结果¶
源码 commit 34148c2e29c01e9be7e4d5b8cbd09fd0f6016902,固定 MiniLM、max_length128、batch16、rank32、两 epoch。LongMemEval 原 JSON 是官方 evaluation instances,本地前100条重新分60 train/20 validation/20 test,仅用于非官方研究诊断;不是官方原 test 成绩或跨数据集泛化实验。训练标签只来自本地 train 查询,validation 选 epoch/α,test 最后评分。原 raw l2_public_dataset 不覆盖,汇总以 l1_mechanism 诊断呈现。
| 共享库100 query(相同切分,seed42/43/44) | Test Recall@10 | Test NDCG@10 |
|---|---|---|
| 同冻结 MiniLM baseline | 0.900000 | 0.715573 |
| Validation-selected sparse fusion / queryadapter | 0.912500 | 0.744397 |
| 预先固定α0.5、无训练 sparse fusion | 0.912500 | 0.757752 |
训练并未显示优于固定 training-free 对照,也不依据 test 的高低重新选择α或 checkpoint。三个 seed 的最终排名指标相同,是相同数据上的随机过程核验,不按独立数据重复计算显著性。
| Seed | 两 epoch MaxSim loss | Validation 选 epoch / α | 选中参数更新 L2 |
|---|---|---|---|
| 42 | 1.729410 → 1.713048 | 2 / 0.75 | 0.191639 |
| 43 | 1.729664 → 1.714434 | 0 / 0.75(训练后未获选) | 0 |
| 44 | 1.729765 → 1.715719 | 2 / 0.75 | 0.189032 |
Seed43 确实执行了两轮真实训练,但 validation 选择初始 identity adapter;不能将其描述为“获选训练模型的提升”。encoder、memory tokens 和 pooled 分支始终冻结。
另存 strict bank-disjoint30、seed42:27 train/1 validation/2 test,baseline Recall@10/NDCG@10 为0.5/0.5,本方法为1/0.715338;validation 仍选 epoch0/α0.25(更新 L2=0)。仅两条 test query,结果只用于连通诊断,不与共享库合并或晋级。
四份原始结果、全部命令与 byte SHA 见 A30 诊断汇总、执行上下文 与 GPU receipt。Receipt/adapter 路径仅为执行后的 artifact metadata 绑定,实际 source 仍为 34148c2e,不是后续绑定提交。设备为 NVIDIA A30。执行证据通过不意味着正式能力比较通过。
代码映射¶
algorithm.py 实现 floor、memory-ID scatter aggregation、标准化融合、范数保持 adapter 和可微 MaxSim CE;experiment.py 实际训练并以 validation 选 checkpoint;../near/data.py 为真实 frozen encoder 与 evaluator 输入边界。未执行全 LMEB、八 backbone、原 QA reader/judge 或索引压缩。没有 Evolve operator,不宣称“登记即可执行”。
测试入口:python -m pytest tests/reproductions/test_oct13_agents_jepa.py,覆盖 floor、未匹配 memory 的全局分支、zero-init identity、范数保持与真实非零梯度参数更新。