Read this paper write-up in English
branch-opd:Branching On-Policy Distillation
核心机制代码路径;短预算 checkpoint 结果只支持 runtime 诊断,不支持论文规模能力结论。
论文信息
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2610.13481 |
| 公司/机构 | Tsinghua University / Peking University / SenseTime Research |
| 首次公开日期 | 2026-10-09(arXiv v1) |
| 原文开源代码 | 否:作者仓库 当前仅 LICENSE/README,尚未提供算法实现(2026-10-12 核查) |
| Adapter | branch-opd |
| 本地复现代码 | src/auto_research/reproductions/branch_opd/ |
原始论文总结
背景与主要改动
普通 OPD 每个前缀只看到一次后续。BranchOPD 用学生不确定性和师生分歧定位 fork,从同一冻结学生策略独立采样 suffix,前缀只计入一次;并用协议事件监督结束行为。分枝不是教师强制 token,也不按答案正确性筛选。
flowchart LR
学生主轨迹 --> 不确定性与分歧排序 --> 选择fork --> 学生策略suffix采样 --> 前缀去重 --> 教师token评分 --> OPD与PBR更新原论文关键图
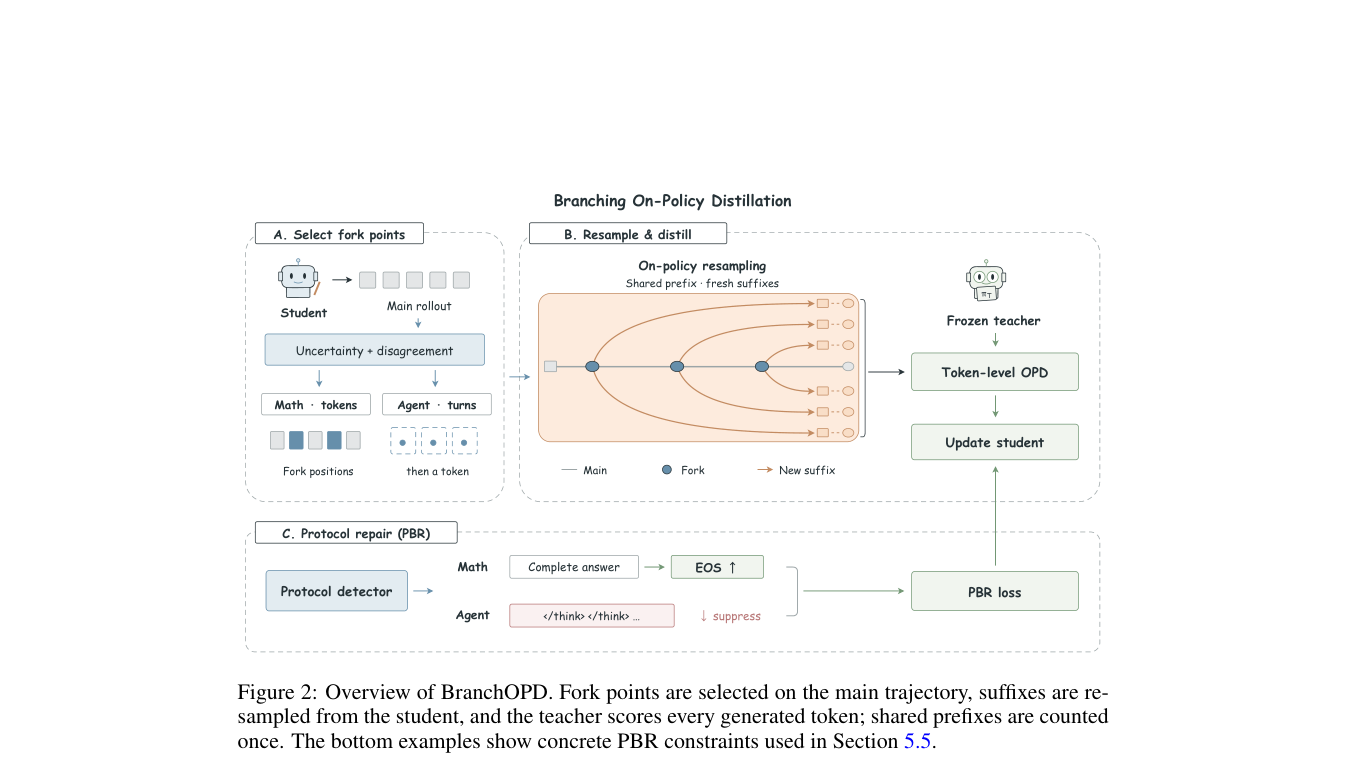
原版 PDF 第 4 页 Figure 2 全页截图,已检查图题、算法流程与正文,非本地重绘或实验产物。版权归原作者;截图来源为官方 arXiv PDF v1。
原论文关键图
原论文 Figure 2(关键图):展示原论文方法的总体设计和关键组成。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\(v_t=\alpha R(U_t)+(1-\alpha)R(D_t)\)。\(A_t=\mathrm{clip}(\mathrm{sg}[\log\pi_T(a_t|s_t)-\log\pi_\theta(a_t|s_t)],-10,10)\);\(L=-\sum M_t\min(r_tA_t,\mathrm{clip}(r_t,0.8,1.2)A_t)/\sum M_t\)。PBR 对检测到的集合事件使用 \(-b\log p(C|s)-(1-b)\log(1-p(C|s))\),本地数学协议在完整 boxed answer 后鼓励 EOS。
论文离线与线上效果
论文 Table 1:数学 avg@16 宏平均 BranchOPD 44.37%,Vanilla OPD+PBR 38.94%,7-rollout OPD+PBR 39.09%。Table 2:ALFWorld ID/OOD 为 57.86%/55.22%。Table 11 测得 ALFWorld/WebShop 生成 token 节约 19.1%/31.2%。未报告线上 A/B。 原论文标量摘录见 paper-results.json,paper_reported=true、measured_locally=false;独立存放于非 metrics 目录,不能作为本地复现指标。
本地复现
本地对照口径:计划基线为相同学生的单轨 OPD,实验组执行 student 分枝采样、teacher 计分与 PBR;本次没有实跑同预算基线,稳定相对提升不适用。
入口:PYTHONPATH=src python scripts/run_oct12_post_training.py --objective branch-opd --help。
必须提供本地 student/teacher checkpoint 路径与公开 ID/revision、公开 train/validation JSONL、dataset revision、train-only split manifest 和 output 路径。 CLI 不下载模型,不上传数据,实际训练 q_proj/v_proj LoRA。
branch-opd packaged adapter 读取数据目录中的 oct12-branch-opd.json,字段对应 CLI 的 snake_case 参数;没有真实 checkpoint 配置时明确报错,不回退到合成 fixture。
数据协议与结果
必须复用 public_holdout.validate_holdout 校验公开 source train、revision、文件 SHA256、条数、规范化 question 去重及 train/validation 不重叠。学生生成只接收问题;gold 不进入 solver rollout/retrieval。validation 仅训练后报告,本短跑没有据 validation 选超参;test 无入口且不读取。正式实验的选参必须仅使用 train/validation。
默认 3 forks×2 continuations;同词表,top-k=0/top-p=1/temperature=1。短预算的最小 fork 间隔为 1 token(显式预算差异)。仅数学单 turn;没有实现 ALFWorld/WebShop 环境快照与多 turn 分枝,不能声称 agent benchmark 复现。
已完成 NVIDIA A100-SXM4-80GB 的真实短预算机制执行,快照为 456a2ffacc47658c4ccb74f386465d47e5f4e357。学生为 Qwen2.5-0.5B-Instruct,冻结教师为 Qwen2.5-7B-Instruct;公开 GSM8K 原 train 的固定 holdout 包含 6757 train / 716 validation,本次仅训练前 2 题并报告前 4 题 validation,不读取 test。seed 42、2 optimizer steps、最多 512 输出 token、3 forks×2 continuations,测量见 gsm8k-a100-42.json。
| step | loss | 梯度 L2(裁剪前) | suffix/主轨迹有效 token | PBR 约束 |
|---|---|---|---|---|
| 0 | 15.453265190124512 | 22.87696075439453 | 1244 | 5 |
| 1 | 13.375693321228027 | 20.84510040283203 | 985 | 3 |
两步实际生成 12 条分枝、有效响应 token 共 2229,共享前缀排除 458 token;PBR 约束共 8,LoRA 参数变化 L2 为 0.008337237479241007。validation exact match 为 2/4(0.5);这不是未训练学生或同预算 OPD 的相对收益,不能由 4 题、单 seed 推断稳定 reasoning 能力。原始统一 budget 中其它 objective 的 priming/rounds/group 等默认项在 Branch 路径未生效,不表示它们也被执行。
GPU 回执 绑定完整执行 commit、公开 checkpoint/data revisions、原始结果 SHA256 和从该 commit 的 git show 独立计算的源码哈希;passed 仅表示该 eager-attention 快照实际执行了分枝/PBR/梯度/参数更新,不覆盖后续 SDPA、当前 HEAD 或 dirty 文件修改。没有复现论文规模、多 turn agent benchmark 或同预算能力对照。
旧 128-token 运行完整脱敏归档在 historical-pbr-unexercised.json,与当前 metrics 分离。它虽然有 12 条分枝和参数更新,但两步 PBR 都为 0、4 题 validation exact match 为 0,标为 not_passed_pbr_unexercised:历史机制验证未通过,不是本次 512-token 运行,也不是同预算基线。旧原始文件 SHA256 保留,不补写其中未记录的执行 commit。
可移植执行命令
在上述执行快照与仓库环境中,将占位符替换为已按 receipt 哈希核验的本地公开缓存/holdout 路径;脚本不下载模型。未覆写的 learning rate=1e-5、PBR weight=1、min fork gap=1 使用该快照默认值。
PYTHONPATH=src python scripts/run_oct12_post_training.py \
  --objective branch-opd \
  --student-path '<student-checkpoint-cache>' \
  --student-id Qwen/Qwen2.5-0.5B-Instruct \
  --student-revision 7ae557604adf67be50417f59c2c2f167def9a775 \
  --teacher-path '<teacher-checkpoint-cache>' \
  --teacher-id Qwen/Qwen2.5-7B-Instruct \
  --teacher-revision bb46c15ee4bb56c5b63245ef50fd7637234d6f75 \
  --train-path '<public-train-jsonl>' \
  --validation-path '<public-validation-jsonl>' \
  --split-manifest '<public-split-manifest>' \
  --dataset-revision 3101c7d5072418e28b9008a6636bde82a006892c \
  --output '<output-json>' --device cuda --seed 42 --steps 2 \
  --validation-examples 4 --max-tokens 512 --forks 3 --continuations 2
代码映射与复现边界
branch_forks / branch_loss / protocol_boundary_loss 对应选择、OPD 和 PBR;branch_step 实际冻结采样组、共享前缀 suffix 采样与 LoRA 更新。
契约与行为测试:test_oct12_post_training.py。小因果模型测试仅验证真实梯度、masked prefix、参考恢复、边界更新及 gold 隔离;不是 reasoning 能力比较。尚未完成论文规模数据/模型/长推理预算、多 seed 同预算能力对照、线上系统或 Evolve 控制器集成。