Read this paper write-up in English
Orthros:阶段异构注意力¶
论文信息¶
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2610.13735 |
| 公司/机构 | The Hong Kong Polytechnic University / University of Chinese Academy of Sciences / University of Sydney |
| 首次公开日期 | 2026-10-09(arXiv v1) |
| 原文开源代码 | 否:截至2026-10-12未找到作者公开源码 |
| Adapter | orthros |
| 本地复现代码 | src/auto_research/reproductions/orthros/ |
PDF另标内部日期October7;本目录首次公开日期以arXiv v1的October9为准。实现为 core_mechanism / L1,已完成A100三seed运行与真实KV一致性验证。
原始论文总结¶
背景与主要改动¶
长 prompt、短回答的推理中,prefill 与 decode 的计算角色不同。Orthros 保留两个 token 流:base tokens 对所有位置执行固定窗口 SWA,并构建完整的逐层 KV;output-specific tokens 只在需预测输出的位置出现,用共享 KV 做全历史 causal cross-attention。FFN、norm 和主要 Q/K/V/O 权重共享,但两种 query 各有可学习 affine 变换。
这里的“线性 prefill”是固定窗口 \(O(Tw)\),不是 kernelized linear attention。prefill 只复制最后一个 prompt token;decode 每步复制一个新 token,两流分别更新KV和检索全局。输出流不写KV,base流的局部读取也不代表丢弃历史KV。
flowchart LR
  A[输入token embedding] --> B[Base stream]
  A --> C[仅复制output位置的Output stream]
  B --> D[共享K V投影与完整逐层cache]
  B --> E[Base query affine与固定窗口SWA]
  C --> F[Output query affine与全历史cross-attention]
  D --> E
  D --> F
  E --> G[共享token-wise RMSNorm与FFN]
  F --> G
  G --> H[仅output stream产生LM logits]
原图检查:已检查 v1 PDF 第5页 Figure1,包含PT/SFT/Prefill/Decode四种双流配置。截图明确同层 K/V 只来自 X,不能替换为跨层缓存或压缩线性状态。
原论文关键图¶
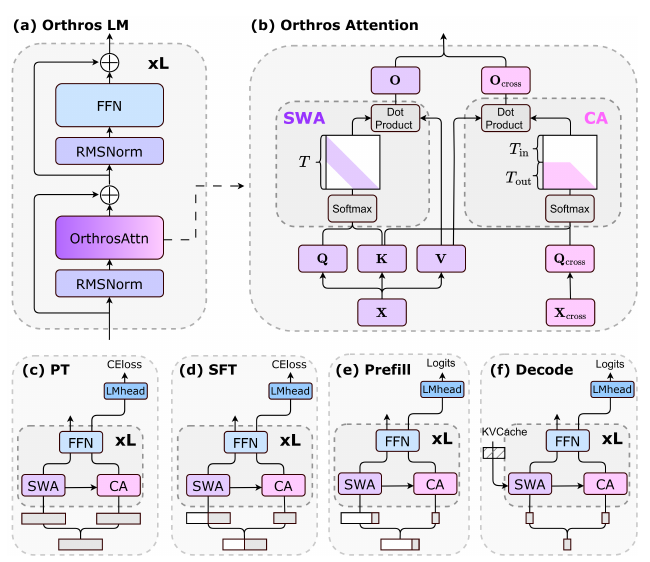
图片来自原论文第5页Figure1,版权归原作者所有;已检查完整双流与四个执行阶段。
核心公式¶
PT时复制整个序列,SFT时只复制回答预测位置;prefill仅最后一个prompt位置执行global retrieval,decode使用完整历史KV。训练损失只从output-specific流计算。来源:原文 §3、Algorithms1–2.
论文离线与线上效果¶
| 原文实验 | Transformer | Orthros |
|---|---|---|
| 1.3B常识任务平均,Table1 | 53.41 | 53.98 |
| Llama3.1转换平均,Table2 | 65.47 | 67.26 |
| 1.3B recall-intensive平均,Table3 | 33.9 | 34.4 |
| H100/SGLang,128K输入128输出TTFT秒,Table4 | 77.249 | 17.016 |
摘要的最高prefill21.9×与Table4的端到端条件不是同一个口径,不能混作同一列;Table4 decode-only tok/s 33.7与33.3也说明不是decode加速承诺。原文实验。线上 A/B:未报告,H100推理实验不是生产随机流量A/B。
本地复现¶
本地对照口径:共享小型预训练起点继续训练的Transformer为基线,转换并真实适配的Orthros为实验组;论文吞吐相对收益不适用,本地只报告固定预算NLL与cached/batch一致性。
同一个真正的 byte Transformer 先在 WikiText train 预训练10步;复制Q/K/V/O、FFN、norm、embedding/head进入Orthros,新增affine初始化为identity;基线和实验组再各训练40步,读取相同train批次。window>=T 时identity-affine转换严格恢复标准Transformer输出。
PYTHONPATH=src python scripts/run_oct12_foundation.py --paper orthros \
  --device cuda --seed 42 --steps 40 --width 64 --layers 2 --window 16 \
  --sequence-length 64 --train-bytes 32768 --eval-bytes 4096 \
  --dataset-dir data/oct12-wikitext --output runs/oct12/orthros-s42
数据协议与结果¶
使用 Salesforce/wikitext pinned revision b08601e04326c79dfdd32d625aee71d232d685c3 的三个官方split。固定byte vocab、预算与window,不使用test调参。哈希验证的offline镜像由 scripts/prepare_oct12_public_sources.py --source wikitext 导出。
2026-10-12 在 A100 完成 seed42/43/44,每组10步共享预训练后分别适配40步。test byte NLL:基线 3.02851 ± 0.05278,Orthros 3.02952 ± 0.05255;实验组略差,保留结果、不宣称提升。真实prefill/decode的batch-cache最大绝对误差 1.43×10⁻⁶,低于预先规定 10⁻⁴ 门槛;完整KV随decode增长。
实测见 wikitext-a100-seeds42-44.json,回执见 GPU证据。短序列、小型byte模型不支持长上下文或21.9×加速结论。
代码映射与边界¶
sliding_window_attention 真正构造 T×window 局部视图,不先生成T×T dense矩阵再mask。OrthrosAttention.forward_pair/decode_pair 执行同层双流共享KV;OrthrosLM.prefill/decode 维护真实逐层完整KV状态;from_transformer 是实际权重转换,runner后续真实backprop训练。
本地是小型learned-position dense LM,而非Llama/Qwen原模型、RoPE128K、SGLang或FlashAttention kernel。global PT cross stream仍有二次计算;不把prefill的理论复杂度改写成训练线性。单seed/短序列结果仅L1,不复现论文21.9×、长上下文能力或生产吞吐。未声明evolve集成。