Read this paper write-up in English
residual-advantage:Residual Advantage: Student-Relative Teacher Guidance for RL with Verifiable Rewards
核心机制实现;短预算真实 checkpoint 运行只验证训练链路,不等同论文规模能力复现。
论文信息
| 字段 | 内容 |
|---|---|
| 论文链接 | 原文 |
| 公司 / 机构 | Harbin Engineering University / Tencent / Harbin Institute of Technology(第一作者署名) |
| 首次公开日期 | 2026-10-08(arXiv v1) |
| 原作者代码 | 截至 2026-10-10 未发现 / 未发布原作者代码 |
| 本地 adapter / 方法(Adapter) | residual-advantage |
| 本地复现代码 | oct10_objectives.py、oct10_checkpoint.py |
原始论文总结
背景与主要改动
把全词表师生概率残差变成相对学生的有界局部优势,再逐响应中心化,与验证器优势相加。Co-RA 在同一已评分学生批次上更新教师 LoRA,下一轮才使用新教师。
flowchart LR
同一学生批次 --> 全词表师生残差 --> 学生期望基线 --> 响应中心化 --> 学生PPO更新 --> 教师LoRA更新 --> 下一轮教师原论文关键图
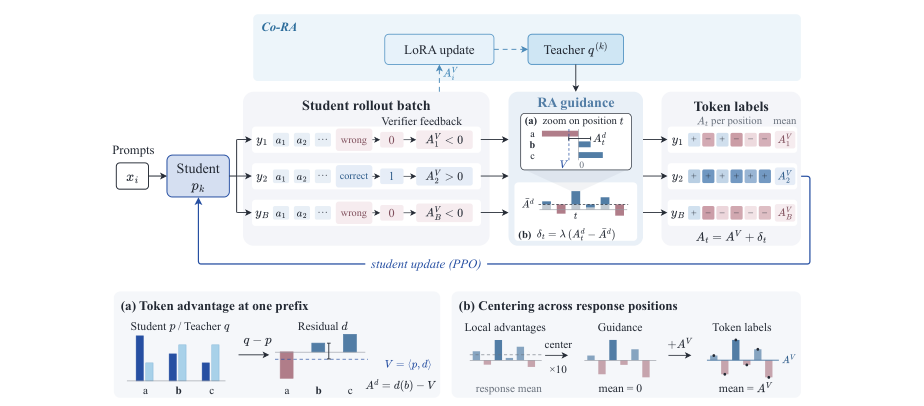
原论文 Figure 2(关键图):学生采样后,验证器提供响应级优势,教师—学生残差形成 token 级指导;按响应位置中心化后更新学生,Co-RA 还通过验证反馈更新教师。图片来自原论文,版权归原作者所有;点击图片可查看来源。
核心公式
\(d=q-p\),\(a_t=d(y_t)-\sum_vp(v)d(v)\);\(A_t=A_{\mathrm{verifier}}+\lambda(a_t-\bar a)\)。Co-RA 的教师更新仅使用固定验证器优势,先评分再分别更新,禁止中途重算标签。
论文离线与线上效果
原文 RA 在 24 组比较中均改进基础序列优势算法,Co-RA 进一步提高 Avg@8。未报告线上 A/B。
本地复现
完整安装、数据格式和命令见checkpoint 运行说明。
核心入口为 residual_advantage / co_ra_step;实际 checkpoint 命令入口是 scripts/run_oct10_post_training.py --objective residual-advantage。同篇的 Co-RA 使用 --objective co-ra。
必须显式提供本地 checkpoint 路径、公开模型 ID/revision、公开 GSM8K train/validation JSONL、数据 revision 和输出目录;运行 python scripts/run_oct10_post_training.py --help 查看完整参数。不自动下载或上传私有数据。教师与学生必须逐 token 词表一致;只支持含 q_proj/v_proj 的因果 LM,基础参数冻结,LoRA 实际训练。
数据协议与结果
生成器只读取问题。答案只用于外部数值验证器。训练与验证问题重叠会报错;训练后才执行隔离验证,不据验证选择超参。报告保存 seed、数据哈希、checkpoint revision、token 数、loss 和实际参数变化。
NVIDIA A100 上已执行真实 Qwen3-4B 学生与公开 MOPD 教师的 LoRA 训练(seed 42,2 步)。学生有效梯度步数 2,adapter 参数变化 L2 为 0.020295。隔离验证仅 2 题,exact match 为 0.5;不能据此宣称收益。详见 实际指标 和 脱敏 GPU 证据。
短生成截断、少量问题和单 seed 只支持 runtime smoke,不支持数学能力提升结论。
Co-RA 另执行 10 步、每题 4 响应、512 token 的同批学生/教师更新:学生 10 步有有效梯度,教师 1 步有有效梯度(峰值 0.124529),教师 LoRA 参数变化 L2 为 0.028806。指导优势响应均值误差最多 \(5.97\times10^{-8}\)。教师仅在完成本轮固定标签更新后于下一轮重新评分;冻结基础参数不进入教师优化器。详见 Co-RA 实际指标,GPU 收据包含该附加命令。小样本验证仍不构成能力比较。
代码映射与复现边界
公式和选择器位于 oct10_objectives.py,LoRA/rollout/教师评分/优化/验证位于 oct10_checkpoint.py,契约测试位于 tests/test_oct10_objectives.py 和 tests/test_oct10_checkpoint_contracts.py。没有完成论文原训练数据、完整训练预算和多 benchmark 对照;未接入 Evolve 多轮控制器,不把方法索引标签当作 Evolve 集成。