Read this paper write-up in English
SmolWAM:保留世界预测的紧凑机器人动作模型¶
当前为
core_mechanism:真实 A100 已完成三 seed 缩放 teacher 蒸馏、两阶段布局课程与新 student LIBERO 闭环,不用 VQA/随机小网络替代。新 student 与 no-op 均无任务成功;原5000步蒸馏未重训,不能称 full_pipeline 或能力提升。
论文信息¶
| 项目 | 内容 |
|---|---|
| 论文链接 | arXiv 2610.13740 |
| 公司/机构 | ML Collective |
| 首次公开日期 | 2026-10-09(arXiv v1) |
| 原文开源代码 | 是:官方/作者代码 |
| Adapter | smolwam |
| 本地复现代码 | src/auto_research/reproductions/smolwam/ |
原始时间为 2026-10-09 15:34:33 UTC。代码固定 dde1e5bfe35c439499343c6d70e9cd32c96d0b36,Apache-2.0;发布权重使用 NVIDIA One-Way Noncommercial License,不因代码开源而允许商业权重用途。Wan VAE 独立为 Apache-2.0。训练、分发和后续应用须分别核对许可。
原始论文总结¶
背景与主要改动¶
Cosmos Policy 将机器人状态、两路相机、动作和未来状态编码为九个 latent frame,沿用视频生成接口:33 帧 VAE、T5-XXL、28-block 2B DiT、1764 tokens 和五步去噪。SmolWAM 并非只换一个轻量 action head,而是在保留预训练 trunk、token 原位置与 rectified-flow readout 的同时,逐项恢复接口改变造成的分布偏移。
单帧 Wan VAE 配合 0.5M adapter,映射回原 clip latent 空间;BERT 特征缓存并填充到 512 positions,保留偏置为零的注意力 sink。保留 block 0–2、19–27,共 12 block / 约 0.85B trunk,加 6 层零初始化 vision-to-language 交互后总模型约 0.88B。28 个 state-conditioned action queries 替代 196-token action frame,保留 blank 与图像,使序列为 1008 tokens。单次 trunk forward 同时读取 16×7 动作和两路 future latent。
架构流程¶
graph LR
 I[单帧两路相机] --> V[Wan VAE与latent adapter]
 T[缓存BERT instruction] --> P[512位置零填充与6层VL交互]
 S[9维机器人状态] --> Q[28个state-conditioned动作queries]
 V --> C[真实Cosmos保留12blocks]
 P --> C
 Q --> C
 C --> R[单步RF clean estimate]
 R --> A[16动作chunk]
 R --> F[两路未来latent]
A --> E[LIBERO执行完整16步后重新观察]上方为本地重绘示意,源码:architecture.mmd;作者仓库另有架构 SVG。source-provenance.json 留存来源和固定版本。

原论文关键图¶
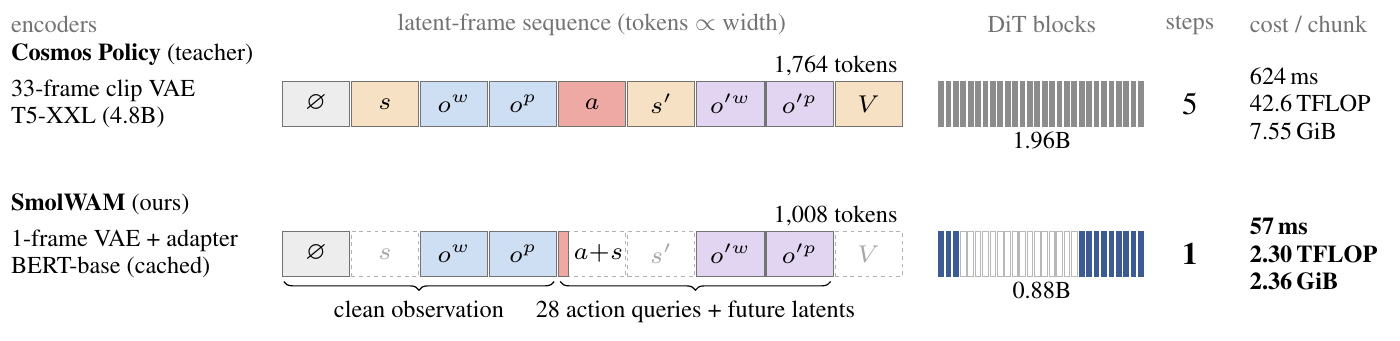
图 1:从 Cosmos Policy 到 SmolWAM,33-frame VAE 改为单帧 VAE 加 adapter,文本改为缓存 BERT;删除 state/value frame,以 28 个 state-conditioned action query 输出动作及未来相机 latent。token 布局由 1,764 压缩到 1,008,DiT 保留 12 个 block,推理从 5 步变为单步。图中延迟、计算量和显存为作者 A100 原始测量,不是本地结果。来源:Owolabi 等,v1 Figure 1,原 PDF 第 2 页。
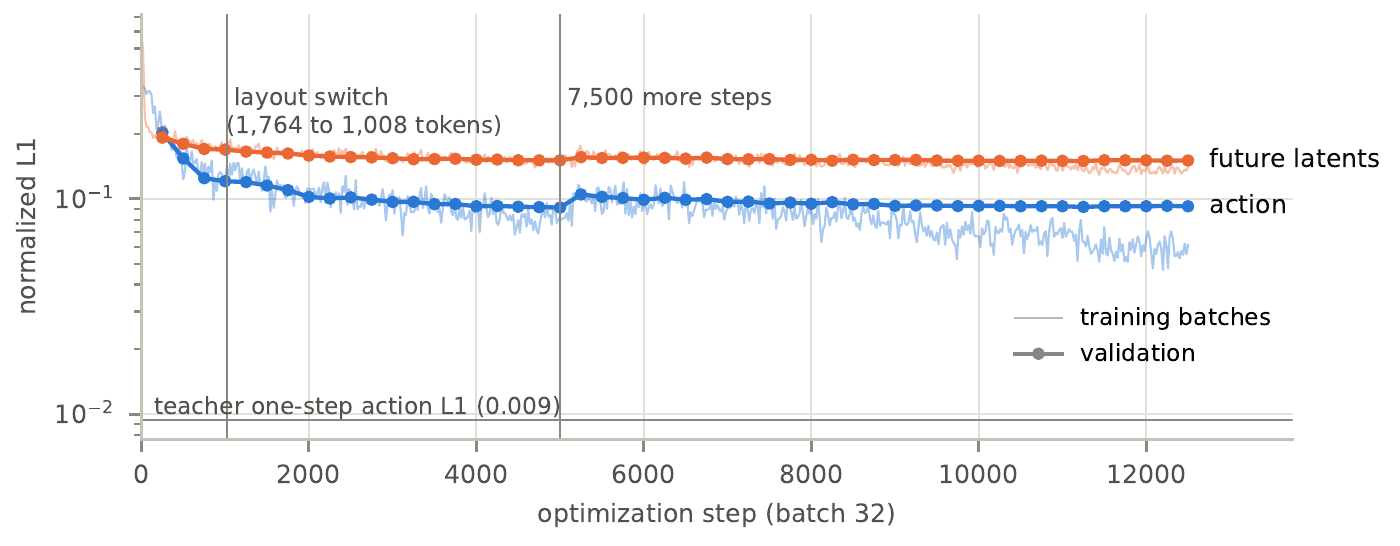
图 4:原作者以 batch 32 训练动作与未来 latent 的 normalized L1;浅线为训练 batch,带点粗线为 held-out validation。两条竖线分别标出 teacher 布局转 compact 布局,以及随后追加 7,500 步训练的起点。此图保留原始长程训练设置,不能当作本轮缩放训练的测量。来源:Owolabi 等,v1 Figure 4,原 PDF 第 8 页。
以上为原文 PDF 的 250 dpi 局部截图,图内文字未改写,已逐张视觉核验。论文图示采用 CC BY 4.0,归原作者所有;这与模型权重的非商业许可证是不同边界。PDF/图片 SHA256、页码与裁切范围见 original-figures.json。原文 Figure 2 的 future 解码仅用于展示,不作为本地世界预测质量的测量。
原论文 Figure 1(关键图):上文说明所选原图或方法截图的范围;并非本地测量。图片来自原论文,版权归原作者所有;点击图片可查看固定版本来源。
核心公式¶
与 LeWAM 的噪声→数据方向不同,这里沿用 teacher 的数据→噪声 rectified flow:
原版预条件化、RoPE 空间 extrapolation=3.0、禁用 fps modulation 均须保留;加载权重成功并不代表错误默认设置下的 trunk 等价。训练四个主要 L1 项为:
第一阶段 1000/5000 步用 teacher 的 1764-token layout 恢复 pruning,随后用 1008-token compact layout;原先存在的状态/value 另有 0.1 权重辅助监督。发布推理只需一次 forward,并不依赖先去噪 future 才能输出动作。
论文离线与线上效果¶
| 原文指标 | SmolWAM | 原文对照 |
|---|---|---|
| LIBERO 400 episodes 成功率 | 95.5%(382/400) | Cosmos Policy 98.2%,teacher 来自较早评测管线 |
| A100 单 chunk 延迟 | 57ms | teacher 五步 624ms |
| 单 chunk FLOPs | 2.30 TFLOP | 42.6 TFLOP,正文计算含 VAE |
| 峰值显存 | 2.36GiB | 7.55GiB |
| 96 留出上下文 future latent L1 | 0.101 | copy-current 0.133 |
| 解码 LPIPS | 0.128 | copy-current 0.115,纹理并未更好 |
来源:原文 §4。Spatial/Object 接近 teacher,Goal/Long 更弱;追加训练、8-block、latent-action cascade 或视觉奖励微调存在负结果。只在模拟 LIBERO 测试、一个训练 seed;未实际验证 edge hardware、真实机器人或生产线上 A/B,不能把论文题目理解为已部署端侧。
本地复现¶
本地对照口径:基线为同固定 LIBERO 初始状态实际执行的 no-op 策略,实验组为各 seed 新训练、validation-selected SmolWAM student;完整 teacher 保持率与相对提速不适用。发布推理入口保留,但本轮成绩不来自发布 student。
PYTHONPATH=src python scripts/run_oct13_robotics.py \
  --paper smolwam --config /path/to/smolwam.json --seed 42 \
  --output runs/smolwam/seed42.json
配置含 source_root、隔离 python、model_dir、vae_dir、libero_root、output_dir、device、固定 tasks 和 trials。每 seed 的方法和 no-op 使用相同初始状态;使用原版倒置图像修正、9维 proprio、10次初始 wait、完整 16-action chunk。future 输出必须实际为 (2,16,28,28) 且有限;不以接口 dummy tensor 代替。没有完整模型/资产会失败,不隐式下载或换代理。
数据协议、结果与边界¶
发布模型 timiiowolabi/SmolWAM revision c269c6e3a9c113b2b04187daf977c09486e2eadc,model 3,517,377,924 bytes,text cache 3,936,048 bytes。Wan2.1 VAE 固定 37ec512624d61f7aa208f7ea8140a131f93afc9a,只读取 507,609,880-byte Wan2.1_VAE.pth,不下载视频 diffusion trunk。LIBERO 原版 Git 固定 8f1084e3132a39270c3a13ebe37270a43ece2a01;仅需代码、assets、bddl、init_files,闭环推理不需要 demonstration 下载。
原作者训练代码完整保留了四项蒸馏、6层 VL 和 layout curriculum。本轮真实生成缩放 teacher targets 并执行 8 步 student 训练,不冒充原版 5000 步训练;新 student 的 world latent 在闭环中实际输出,但尚未对真实 future 计算原文图像指标。限定任务/episode 和三 seed 仍不是原版 400-episode benchmark。公式测试证据见 implementation-contract.json,不当作 GPU 闭环结果。
2026-10-14,冻结 2b84c377 在真实 A100 完成三 seed 的 Wan-VAE latent bank→28-block/T5 teacher targets→12-block student 两阶段课程→新 student 同任务闭环。每 seed 前 8 demonstrations 共 202 rows,32 train/24 validation rows;teacher targets 全量覆盖 202 rows,teacher-vs-demo action L1 约 0.0090183。每 seed 有 8 次非零梯度优化调用、7 次实际参数变化(首步原生 warmup LR 为 0),1764/1008-token 布局分别执行 2/6 步,四项主要 loss、总 loss、validation 与辅助项均有限。
| Seed | 最优 compact validation action L1 | 参数抽样差异 L2 | 新 student / no-op 成功 | 训练+闭环总耗时 |
|---|---|---|---|---|
| 42 | 0.332996 | 0.008666 | 0/2 / 0/2 | 352.48 秒 |
| 43 | 0.348870 | 0.010348 | 0/2 / 0/2 | 353.11 秒 |
| 44 | 0.325485 | 0.010461 | 0/2 / 0/2 | 351.01 秒 |
每 seed 使用 libero_goal:6(cream-cheese-in-bowl)的 2 trials、300-action 预算;新 student 和 no-op 采用相同初始状态。各 student 实际执行 600 个动作、38 次模型查询并输出动作/未来 latent;两个控制臂均为 0% ± 0%,无任务成功或相对提升结论。每 seed 总墙时硬限 1800 秒。完整 loss/gradient/权重与实现 SHA 绑定、6 份 exact raw JSON 见 真实训练与新 student 指标;脱敏 GPU 回执证明缩放定义链路执行,不证明原论文能力或完整 benchmark 复现。旧 2a061dd6 失败不混入新三 seed。
代码映射¶
| 本地文件 | 原文/作者对应 |
|---|---|
algorithm.py |
§3 clean readout、布局课程、四项 distillation loss、发布结构合同 |
worker.py |
实际 SmolWAM.from_pretrained + predict_action(return_future=True) + LIBERO step |
../lewam/external.py |
源码 pin、provenance SHA、离线子进程、失败/超时保留 |
paper.yaml |
CUDA receipt 门禁、core_mechanism 与明确未重训组件 |
测试入口为 python -m pytest tests/reproductions/test_oct13_agents_jepa.py。模拟器依赖 robosuite==1.4.0、mujoco==3.3.2,不同于 LeWAM;两者不能覆盖共享环境版本。
LIBERO 固定版本的初始状态是 NumPy 数组;新版 Torch 默认 weights-only 反序列化会拒绝它。适配器仍使用作者相同 init_files 路径,先核固定 public revision 与精确文件 SHA,再在局部 safe_globals 中允许 ndarray/dtype/reconstruct 与 Float32/64 dtype,显式保持 weights_only=True。未知 pickle 类型仍拒绝;不改作者源码 pin、共享 Torch 或全局加载策略,退出后保留原 allow-set。
接受范围中的真实 teacher 蒸馏与布局课程¶
2026-10-14 冻结 2a061dd6 的真实 A100 seed42 运行已生成前 8 demonstrations 的 202-row latent bank,但在 teacher KD 模型构造时失败:原生接口期望 adapter-only safetensors,而完整发布 student 文件中的 768 维文本层与正确 T5 teacher 的 1024 维结构冲突。失败与 bank 原样保留,未启动 seeds43/44,没有 teacher targets、student 更新或新 student 闭环成绩。脱敏失败记录不是通过回执;teacher 的 T5、28 blocks 与1764-token布局不会为迁就该输入而改成学生结构。
训练 manifest 额外绑定本地共享 lewam/external.py 和 SmolWAM 的 algorithm.py、training.py、worker.py 的实际 SHA256,闭环前必须一致。更新计数必须是正整数、参数差异必须是正有限数;NaN/Inf、非整数计数或实现变化均拒绝加载候选。
manifest 同时保存实际四项 demonstration/teacher loss、总 loss、validation 与两种 token-layout 的梯度/参数差异 trace,并在训练记录与闭环加载两端检查必需字段、有限性和计数一致。新 student 的本轮评测必须显式设置 tasks=["libero_goal:6"](与单任务 cream-cheese-in-bowl 演示一致),不能借用默认其他任务冒充同任务对照。
训练两机制仍在本轮接受 scope 中。--phase train 调用固定作者 smolwam.train.bank:main、smolwam.train.kd_targets:main、smolwam.train.train:train,不是只链接 upstream。真实公开 demonstrations 经 Wan VAE 编码;真实 28-block Cosmos teacher 在同输入/固定噪声下生成 action/future targets;保留 12 block 的 student 先用 1764 tokens,再用 1008 tokens 进行四项 L1 更新。
PYTHONPATH=src python scripts/run_oct13_robotics.py --paper smolwam --phase train \
  --config /path/to/smolwam-train.json --seed 42 --output runs/smolwam/train-seed42.json
训练配置除既有资源外须有 teacher_dir 与 training_data_dir;默认按源顺序取前8 demonstrations、训练8步、curriculum_fraction=0.25,即2个 teacher-layout 与6个 compact-layout 优化步;max_training_rows=32、batch1。原始 latent adapter/BERT text cache 复用发布版,没有声称重新训练单帧↔clip adapter。teacher .pt 与缓存 T5 .pkl 仅从逐文件 hash 核验的官方固定版本加载。
原生 KD/student 的 --adapter 接口只接受冻结 latent adapter。为兼容作者仅发布完整模型文件的资源,本地从已验 model.safetensors 仅提取完整 adapter.* 和 adapter_inv.*,按作者正向/逆向模块模板严格核对全部 key、shape 与有限值,写独立派生 safetensors,并记录完整公开文件 SHA→派生 SHA/key 清单。发布模型的 trunk、text projection、VL、state/query 等权重不会注入 teacher 或新 student;教师仍用原生 T5/28 blocks/1764 tokens,学生仍以固定原生 12-block 配置从 teacher 初始化,其配置逐字段与发布结构一致。该兼容修复不等于后续 GPU 已通过。
| 增量训练资源 | 固定版本 | 文件/体积 |
|---|---|---|
nvidia/Cosmos-Policy-LIBERO-Predict2-2B |
cb689ec0e3347c13667d70a78a3447388f5c3bb8 |
Cosmos-Policy-LIBERO-Predict2-2B.pt 3,913,017,345 bytes;libero_t5_embeddings.pkl 41,957,938 bytes;libero_dataset_statistics.json 2,372 bytes |
nvidia/LIBERO-Cosmos-Policy |
b463cbd5d114909e4daea65eb03bed9787290042 |
单任务 success_only/libero_goal_regen/put_the_cream_cheese_in_the_bowl_demo.hdf5 143,770,729 bytes;success_only/dataset_statistics.json 2,372 bytes |
全量 success_only 为约14.84GB,不在该限量方案中下载。增量 teacher+单任务约4.10GB,可放在本轮20GB总预算内;由主代理统一下载,入口不下载资源。
许可再核验:固定版本Cosmos teacher model card 也明确为 NVIDIA One-Way Noncommercial License(NSCLv1),不允许商业用途;演示数据说明 为 CC BY 4.0。复用 latent adapter、蒸馏和导出 student 不会解除 teacher 的权重许可边界。
一个必须显式记录的 bounded-data 修正:作者 KD 默认 val_frac=0 仍排除一个 episode,单任务规模下它恰好可能排除全部 student validation KD rows。本地仅在 teacher inference 缓存阶段 对所有 bounded bank rows 生成真实 targets,包括 validation;student split/validation选checkpoint逻辑不变,未给 student train-loader 加入 validation 行,未修改 upstream pin。training.py 强制两种布局都有真实非零梯度/参数更新,所有四项 loss 实际存在、validation 非空,并只接受 compact-layout validation 选择的 checkpoint。
此训练入口与新 student 同任务闭环已由上述三 seed A100 证据验证;8 步仅是缩小训练机制诊断,不代表原68,830row/5000step效果。重新训练 latent adapter、完整训练、多任务数据覆盖、原400-episode闭环和teacher闭环比较仍未完成;发布版推理不能被写成这些阶段已复现。
新 student 的 native-training/student/training-provenance.json 绑定真实训练的 seed、作者版本、公开数据、非零梯度/参数更新,以及 validation-selected best.pt 的 SHA256。闭环配置通过 trained_model_dir 读取它;先严格检查 12 blocks、6 VL layers、512位置文本和1008-token compact布局,再加载实际新 student 全部权重。VAE、文本缓存和归一化仍来自已验发布资源。新 student 与 no-op 在每个 task/trial 使用相同初始状态,结果固定为 bounded diagnostic、不可 promotion;上述回执绑定的是该新 student 入口的实际执行。